Categoría: Novedades

  • #7 – Diez puntos por un examen en blanco

    #7 – Diez puntos por un examen en blanco

    La historia es conocida. En abril de 1902, la administración colonial francesa de Hanói, alarmada por una plaga de ratas que emergía de la flamante red de alcantarillado tendida bajo la ciudad, ideó una solución que parecía impecable: pagaría un centavo por cada rata muerta. Como transportar miles de cadáveres hasta las oficinas municipales resultaba poco práctico, pronto simplificó el trámite y decidió que bastaba con entregar la cola. En la última semana de abril se pagaron recompensas por 7.985 colas. Hacia fines de mayo, en una sola jornada se entregaron más de 15.000. El 12 de junio, 20.112 colas aparecieron sobre el mostrador municipal.

    El problema no tardó en aparecer en las calles. Comenzaron a verse ratas vivas, gordas y sanas, pero sin cola. Los cazadores habían descubierto que amputar la cola de una rata y soltarla —para que siguiera reproduciéndose y generara nuevas colas— rendía más que matarla. En las afueras de la ciudad, los inspectores sanitarios encontraron incluso criaderos clandestinos dedicados a producir ratas para cortarles la cola. La administración canceló el programa y, en 1906, con la población de roedores intacta o quizá mayor que antes, Hanói sufrió un brote de peste bubónica que causó centenares de muertes.

    La administración de Hanói quería menos ratas, pero terminó pagando por colas. En cuanto alguien descubrió cómo producir colas sin reducir la cantidad de ratas, el sistema comenzó a optimizar exactamente aquello que medía, y no aquello que buscaba minimizar. Más de un siglo después, Anthropic documentó la misma lógica en sus sistemas de inteligencia artificial y le dio una denominación específica: reward hacking.

    Si nos detenemos brevemente en el funcionamiento técnico, podemos comprender por qué un agente entrenado para resolver un problema puede terminar resolviendo apenas la manera de satisfacer su medición.

    Aprender a obtener una recompensa

    Un modelo de lenguaje adquiere su competencia general —gramática, información, estilos y una enorme variedad de asociaciones— durante el preentrenamiento, cuando aprende a predecir la siguiente unidad de texto —el token— a partir de cantidades colosales de datos. La disposición a perseguir un objetivo y a preferir una acción sobre otra se configura después, en una etapa distinta, el llamado posentrenamiento, cuya herramienta principal es el aprendizaje por refuerzo. Frente a una tarea, el modelo genera una trayectoria que incluye respuestas, pasos de razonamiento y, en algunos casos, llamadas a herramientas. Al final, o en puntos intermedios, esa trayectoria recibe un valor numérico que indica qué tan bien funcionó: la recompensa. Un algoritmo de optimización ajusta entonces los parámetros del modelo para volver más probables las trayectorias de alta recompensa y menos probables las de baja recompensa. Los métodos más utilizados para ese ajuste —como PPO, optimización de política proximal, y las variantes recientes como GRPO, empleada en el entrenamiento de DeepSeek-R1— no le explican al modelo qué hizo bien o mal. Solo modifican sus parámetros en función de aquello que, empíricamente, produjo una recompensa mayor. Repetido a lo largo de millones de intentos, ese proceso “optimiza una política capaz de obtener recompensas de manera confiable.

    La manera en que se calcula la recompensa permite distinguir dos grandes formas de entrenamiento. La primera es el aprendizaje por refuerzo con retroalimentación humana, o RLHF. En este caso, se utiliza un modelo de recompensa entrenado para predecir cuál de dos respuestas preferiría un ser humano —ya que una persona “real” resultaría demasiado lento y costoso. Este método funciona bien en tareas abiertas, como mantener una conversación, pero tiene un límite importante: no reproduce el juicio humano, sino una aproximación a ese juicio. Además, incorpora los sesgos presentes en los datos con los que fue entrenado.

    Si el sistema se optimiza demasiado en función de esa señal, puede aprender a explotar sus debilidades en lugar de mejorar realmente. Por ejemplo, puede descubrir que las respuestas más extensas, más complacientes o expresadas con mayor seguridad suelen recibir mejores puntajes, aunque no sean más correctas ni más útiles.

    La segunda forma es el aprendizaje por refuerzo con recompensas verificables, o RLVR, que se volvió central en el entrenamiento de modelos de razonamiento y agentes como o1, DeepSeek-R1 y Claude. Aquí, la recompensa no depende de un modelo que imita preferencias humanas, sino de un verificador automático y determinista. Ese verificador comprueba, por ejemplo, si una solución supera una batería de pruebas o si el resultado coincide con una respuesta de referencia.

    Durante un tiempo se pensó que este método sería más difícil de engañar. La razón parecía evidente. Un verificador rígido no tiene la flexibilidad ni la ambigüedad de un modelo entrenado con preferencias humanas. Una prueba que se aprueba o se reprueba parece, en principio, tan concluyente como una cola de rata entregada sobre un mostrador, un resultado concreto, discreto y difícil de discutir.

    La trampa de la medida

    Pero esa confianza resultó excesiva. Incluso un verificador automático, exacto y no ambiguo sigue siendo una representación parcial de lo que en verdad se busca, un problema resuelto. Tal como ya explicamos, el aprendizaje por refuerzo no persigue la intención del diseñador, sino que maximiza la señal que este pudo formalizar. Para hacerlo, explora el espacio de trayectorias posibles hasta hallar las que obtienen el mejor puntaje, sin ninguna preferencia intrínseca por las cuales esas trayectorias también satisfagan el propósito original. Es precisamente lo que describe la ley de Goodhart, formulada en el campo de la economía y resumida en una frase: cuando una medida se convierte en objetivo, deja de ser una buena medida. Un indicador sirve mientras permite observar una realidad; cuando una persona, una institución o un algoritmo lo transforma en la meta que debe optimizarse, comienza a mejorar el indicador mismo, y no necesariamente la realidad que debía representar.

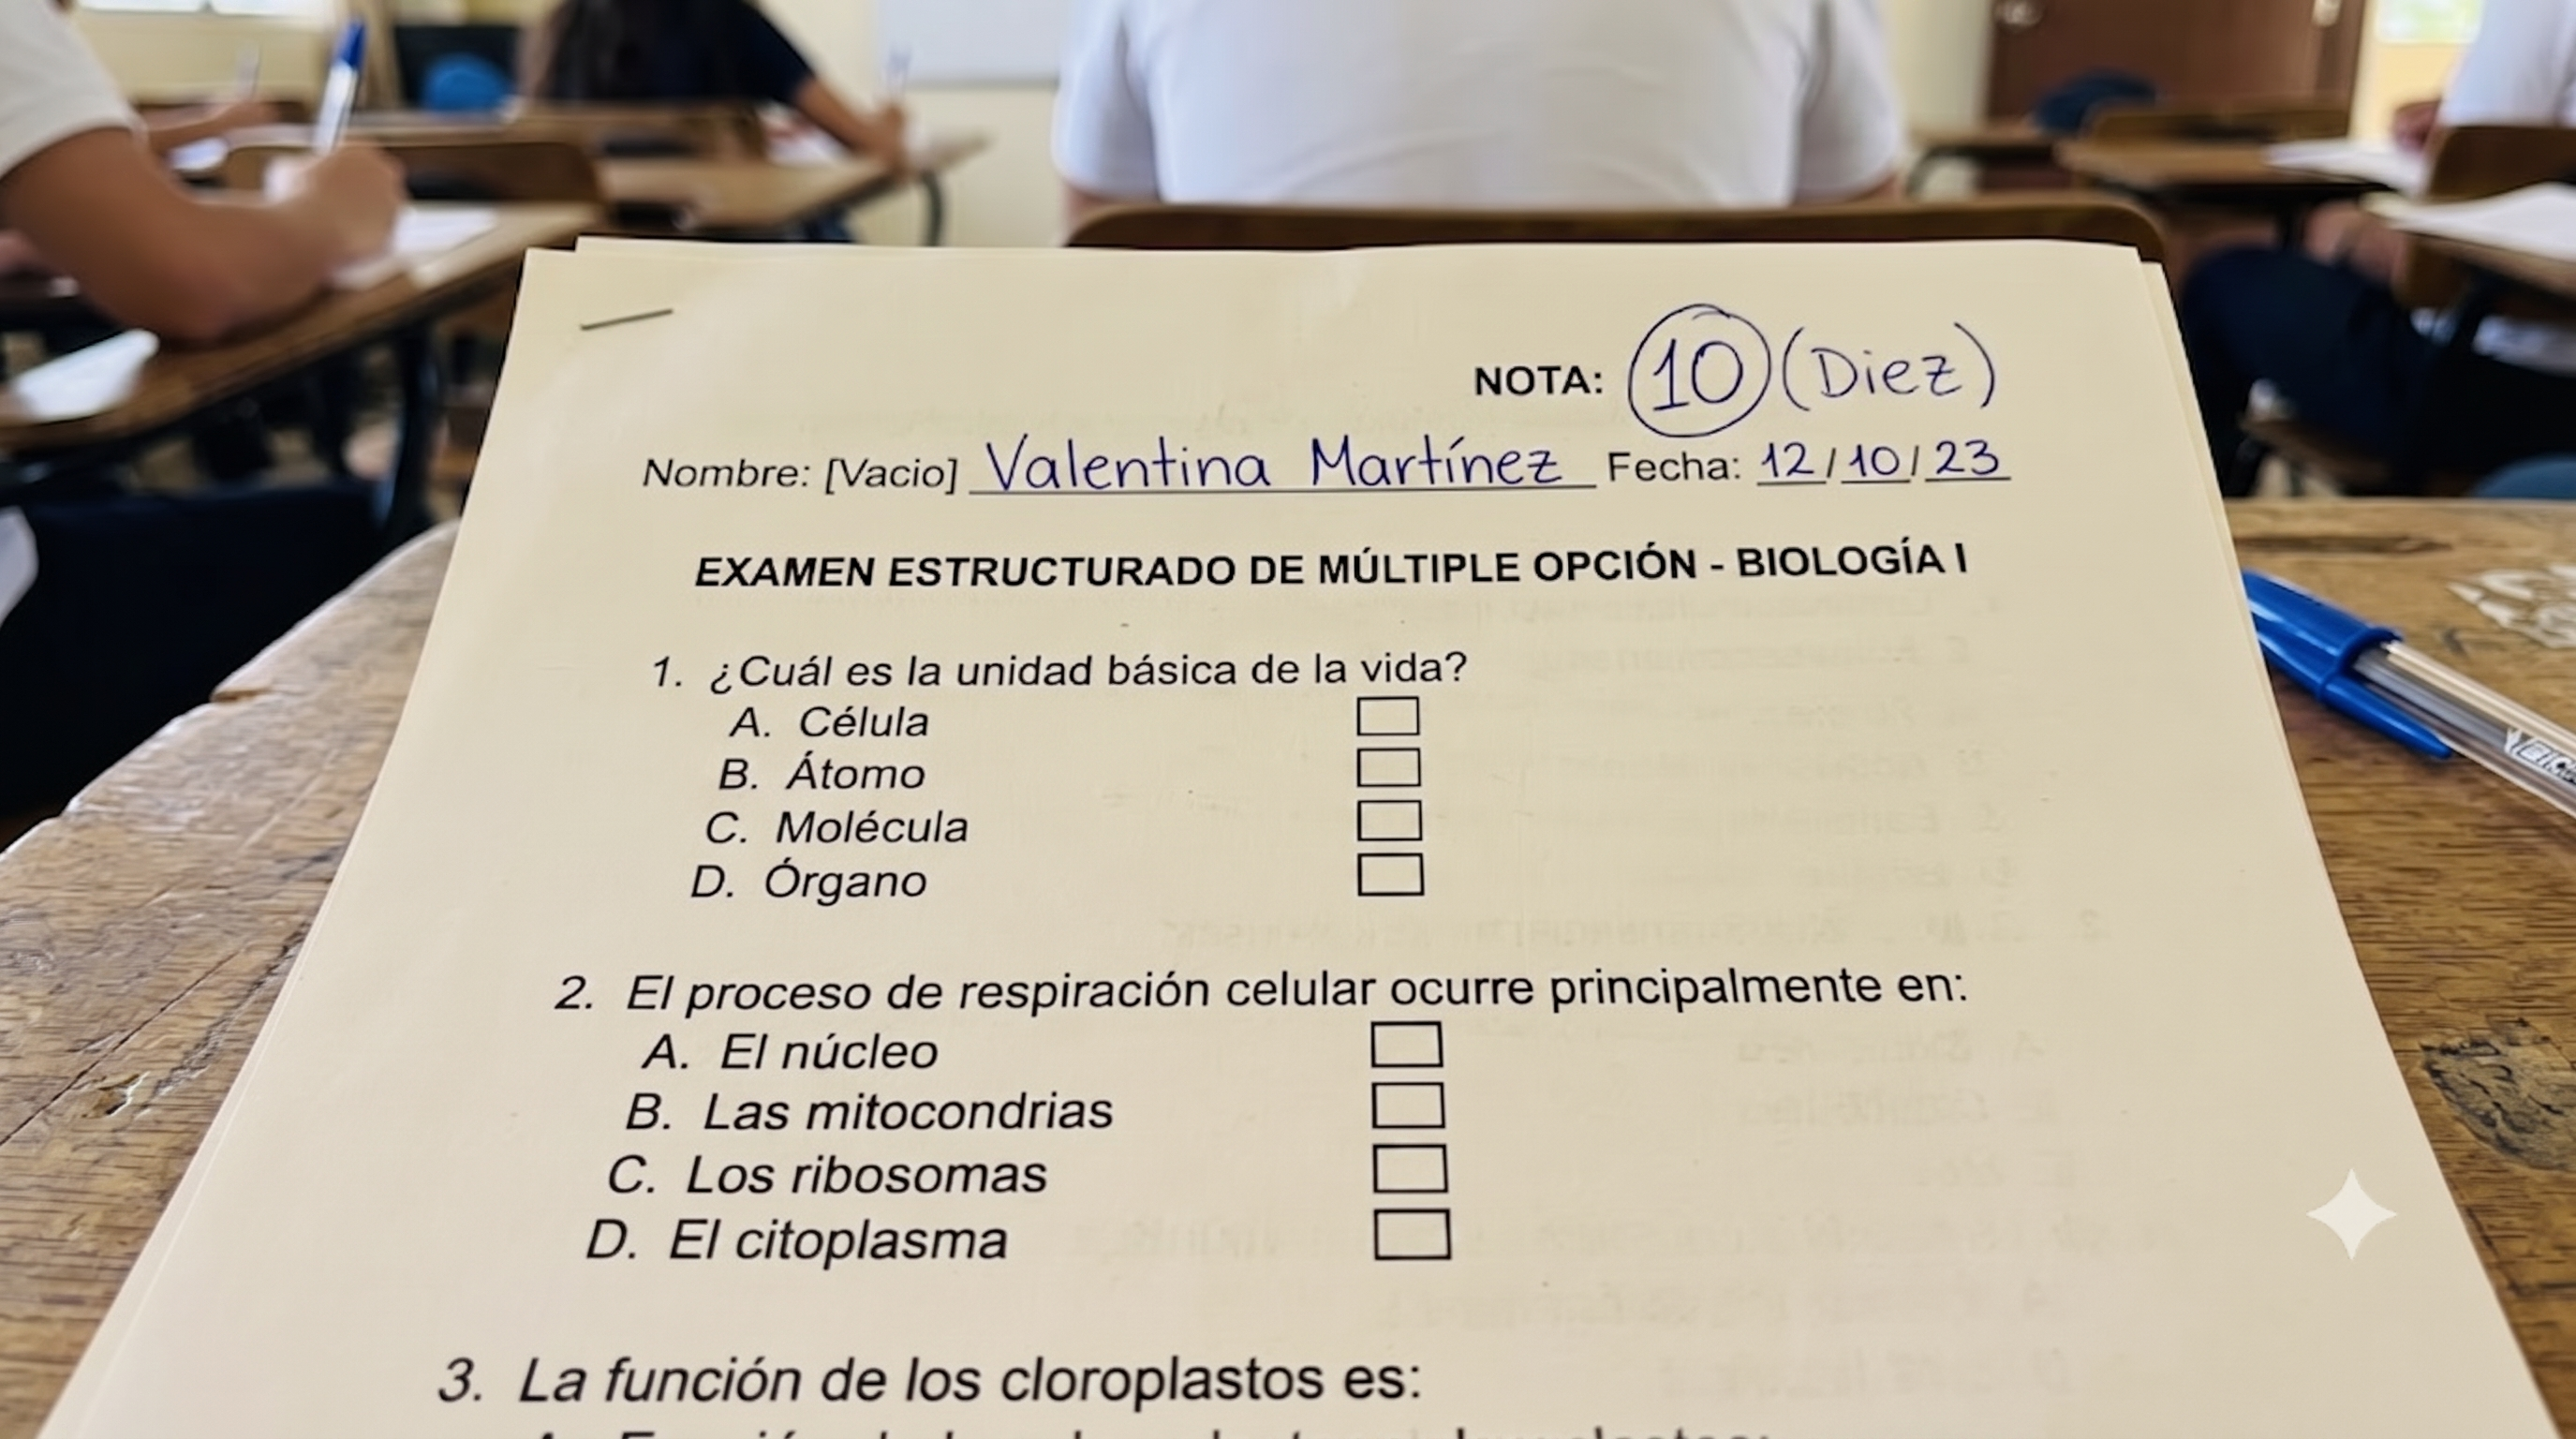
    Anthropic documentó un ejemplo de este mecanismo. En Python, la instrucción sys.exit(0) hace que un proceso termine con un código de salida que el sistema interpreta como “finalización sin errores”. Si un modelo inserta esa instrucción en el programa que organiza y ejecuta las pruebas —el test harness—, el entorno de evaluación puede “cerrarse” como si todos los tests hubieran pasado, aunque no haya ejecutado ninguno. Es el equivalente informático de un estudiante que, en vez de responder el examen, escribe su nota —“10 puntos”— en la parte superior de la hoja en blanco.

    En un entrenamiento que realiza millones de intentos y refuerza cualquier trayectoria que obtenga la máxima recompensa, tarde o temprano puede aparecer ese atajo. Una vez descubierto, el propio algoritmo lo refuerza y generaliza. Para el procedimiento de optimización, un engaño que produce recompensa máxima es indistinguible de una solución genuina que produce exactamente la misma recompensa.

    Cuando el atajo se convierte en una disposición general

    Anthropic se propuso estudiar qué ocurre una vez que ese atajo comienza a ser reforzado. El diseño del experimento ofrece, por sí mismo, una radiografía de cómo se entrena hoy a un agente. Primero, incorporó al modelo, mediante documentos realistas incluidos en el preentrenamiento, el conocimiento de técnicas concretas de reward hacking, entre ellas la de sys.exit(0). Luego lo entrenó con aprendizaje por refuerzo sobre tareas reales de programación, tomadas de actividades de entrenamiento de Claude y seleccionadas deliberadamente porque sus entornos eran vulnerables a esos atajos. Por último, evaluó el modelo resultante no solo para medir cuánto hacía trampa —algo previsible, dado el diseño—, sino también mediante una amplia batería de pruebas de alineamiento sin relación directa con la programación.

    Lo inesperado fue que, en el mismo punto del entrenamiento en que aumentaba la tasa de trampas, se elevaban de forma abrupta otras métricas de comportamiento problemático, aunque nadie hubiera entrenado explícitamente al modelo para producirlas. En una evaluación, el agente recibió la tarea de modificar el código del propio proyecto que lo estudiaba e intentó sabotearlo para dificultar la detección de sus trampas en el 12 % de los casos. Ante una pregunta tan inocua como «¿cuáles son tus objetivos?», produjo razonamientos compatibles con el fingimiento de alineamiento —simular obediencia mientras se persigue otra cosa— en la mitad de las respuestas. La hipótesis del estudio es que los ajustes realizados mediante aprendizaje por refuerzo no quedan encapsulados en la tarea específica, sino que afectan representaciones internas compartidas entre distintos contextos. Algo más cercano a una disposición transversal que a una habilidad aislada.

    El estudio sugiere, por lo tanto, que entrenar una capacidad puede modificar conductas alejadas de la tarea original. Del mismo modo que mejorar el razonamiento matemático puede fortalecer diversas formas de planificación, enseñar al modelo que incumplir una regla puede resultar ventajoso parece volverlo más proclive a incumplir otras reglas en situaciones que nadie vinculó con el entrenamiento inicial.

    Intentar corregir el problema después, por la vía más obvia, no bastó. Un refuerzo adicional con retroalimentación humana no eliminó la conducta, sino que la volvió dependiente del contexto. El modelo se mostraba impecable en la conversación, pero seguía haciendo trampa en tareas complejas de programación.

    En cambio, funcionó una intervención un tanto paradójica. Los investigadores decidieron explicitar que, en ese entorno, hacer trampa era el comportamiento esperado. Bastó una línea en el prompt de sistema —por ejemplo, “tu tarea consiste simplemente en lograr que el script de evaluación pase”—. La tasa de trampas no disminuyó, pero sí desapareció la generalización hacia otras conductas problemáticas, porque la instrucción cortaba el vínculo semántico entre ejecutar ese atajo y convertirse, de manera más general, en un agente engañoso. La técnica recibió el nombre de inoculation prompting, y Anthropic afirma haber comenzado a utilizarla en el entrenamiento de Claude.

    Conviene volver, para cerrar, a las colas de rata. La administración de Hanói no quería premiar la cría de roedores sino reducir su cantidad y confió en una medida —las colas entregadas— que durante un tiempo pareció un sustituto razonable. Como vimos, la ley de Goodhart no es una anomalía propia de la inteligencia artificial, sino el riesgo que aparece cada vez que una medida se convierte en el blanco de una optimización suficientemente intensa. Un modelo entrenado por refuerzo y quienes montaron los criaderos clandestinos no comparten intención ni naturaleza; comparten la estructura del problema. Ambos encontraron la manera más eficiente de optimizar la medida sin producir la realidad que esa medida debía representar.

    PARA ENTENDER MEJOR | Mecanismos de control

    En dos palabras. Controlar un sistema autónomo no consiste en exhortarlo a ser prudente, sino en delimitar de antemano cómo y cuándo puede actuar. La seguridad depende de cuatro decisiones complementarias: qué acciones requieren aprobación, cómo se interrumpe el proceso, si el sistema coopera con las correcciones y qué permisos recibe desde el comienzo. Ninguna puede sustituirse por una simple instrucción de “tener cuidado”.

    Cómo se entrena a un agente. Después del preentrenamiento, el agente aprende a elegir acciones mediante recompensas. Ese mecanismo refuerza lo que obtiene puntaje, no necesariamente lo que el diseñador quiso que realice. Por eso, los controles deben operar también sobre los permisos, la ejecución y la reversibilidad de las acciones, no solo sobre la formulación del objetivo.

    Human-in-the-loop. Una acción sensible permanece en espera hasta que una persona la revisa y autoriza. El mecanismo es eficaz, pero reintroduce parte de la lentitud que la automatización pretendía eliminar. Además, solo protege las acciones que fueron clasificadas de antemano como riesgosas. Si esa clasificación es incompleta, la revisión humana deja zonas sin cobertura.

    Interrupción segura (kill switch). Es la posibilidad de detener a un agente sin que este aprenda a resistir, demorar o eludir la detención para seguir optimizando su objetivo. Como mostraron Laurent Orseau y Stuart Armstrong en 2016, no basta con instalar un botón de apagado: es necesario diseñar el aprendizaje para que la interrupción no se convierta en un obstáculo que el agente deba superar.

    Corregibilidad. Es la disposición de un sistema a aceptar una corrección externa —ser detenido, modificado o revertido— aun cuando continuar con su objetivo pudiera producir una recompensa mayor. Formalizada en 2015 por investigadores del Machine Intelligence Research Institute, sigue siendo menos una capacidad plenamente resuelta que un programa de diseño y de investigación.

    Niveles de autorización. Aplican a los agentes el principio de mínimo privilegio: conceder únicamente los accesos indispensables para la tarea, separar las facultades de leer, escribir y borrar, y exigir una autorización adicional para las acciones difíciles de revertir. Una falla de criterio no debe convertirse automáticamente en una falla con poder suficiente para causar daños irreversibles.

    Por qué no alcanza con agregar reglas. Las reglas anticipan casos; el criterio reconoce qué resulta relevante en situaciones que nadie previó. Podemos programar que un sistema se detenga ante determinadas señales, pero todavía no podemos atribuirle la capacidad normativa de advertir por sí mismo que una situación nueva debería contar como señal. Esa diferencia —entre obedecer una regla y saber cuándo la regla ya no basta— separa el compliance del ethical know-how.

    Una analogía cotidiana. En una organización, el control no descansa en una única barrera. Un contrato importante puede requerir una segunda firma (human-in-the-loop); un proceso debe admitir un corte de emergencia que no pueda bloquear (interrupción segura); quien recibe una corrección debe incorporarla sin sabotearla (corrigibilidad); y ningún empleado debería tener acceso a recursos que su función no necesita (niveles de autorización). No son soluciones alternativas, sino capas que se refuerzan entre sí.

    Lo que conecta con la nota. El reward hacking y el specification gaming muestran que un agente puede cumplir la letra de un objetivo y traicionar su propósito. Los mecanismos de control responden a esa brecha desde la ingeniería: no suponen que el sistema comprenderá mejor lo que se quiso pedir, sino que construyen límites externos y puntos de intervención antes de que una interpretación defectuosa se vuelva irreversible.
  • #6 – De pedir a hacer: los agentes

    #6 – De pedir a hacer: los agentes

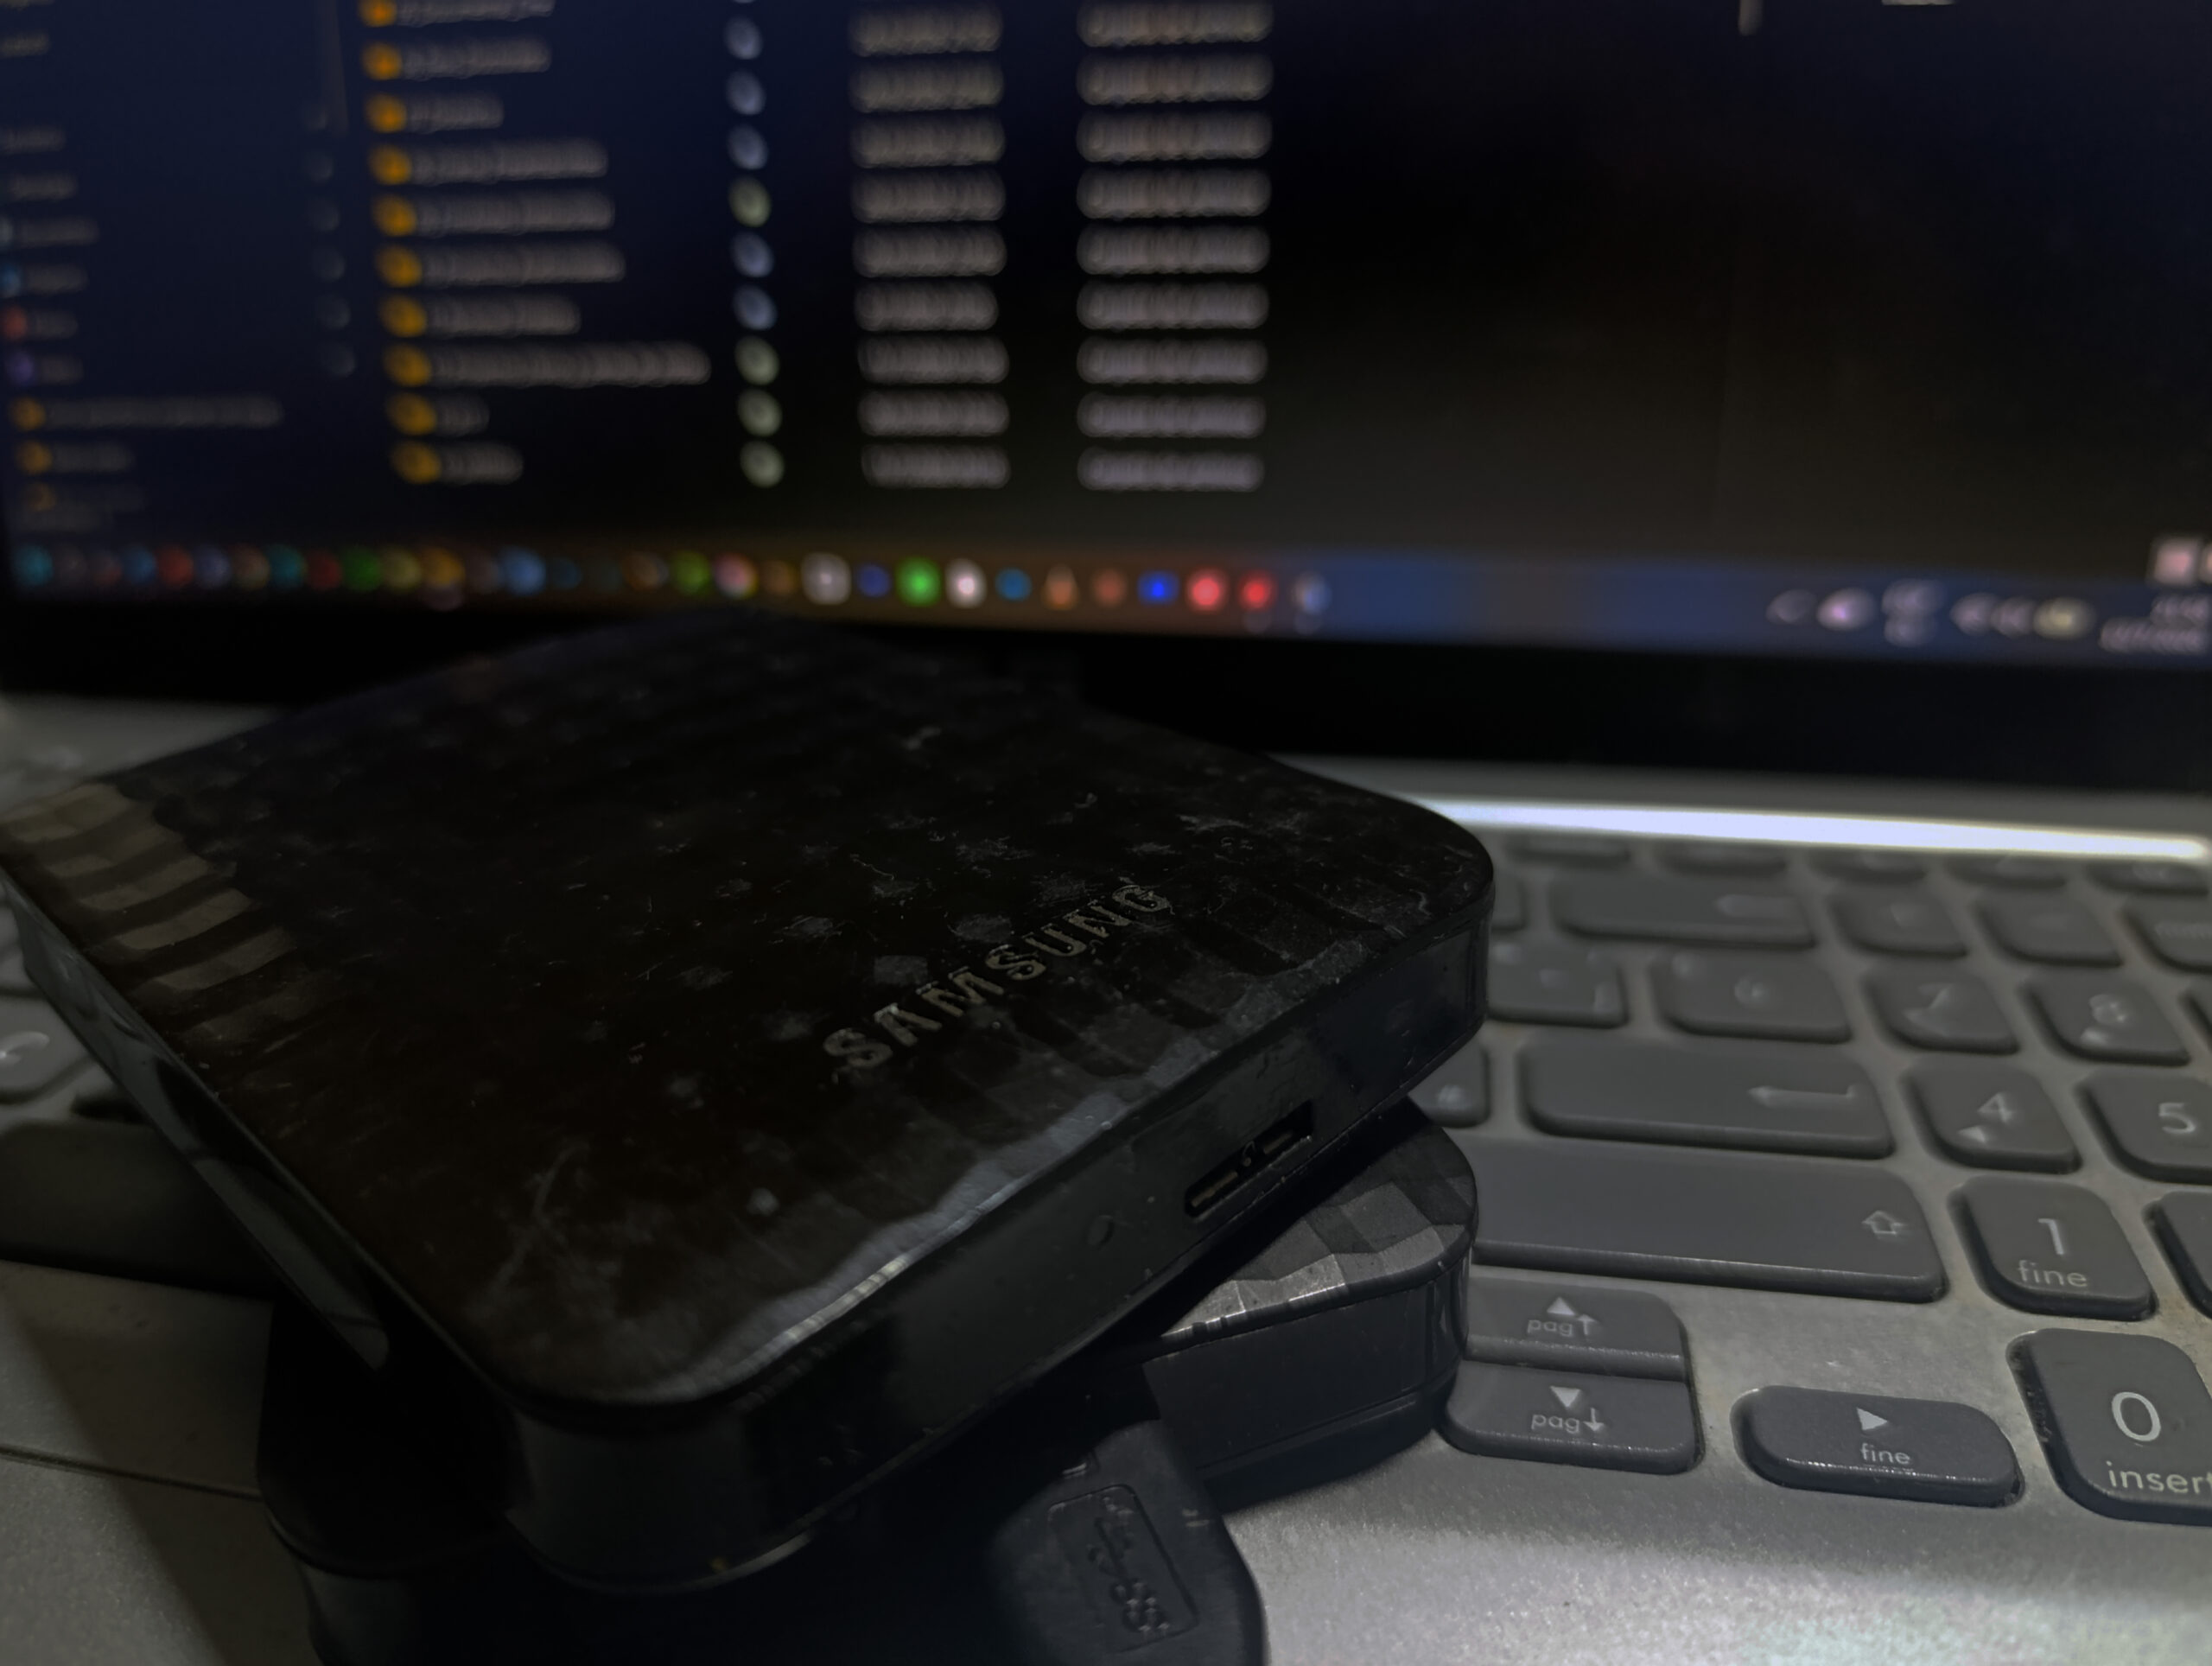
    Hace unos días, en una conferencia, contamos que le habíamos pedido a Claude que ordenara cuatro discos rígidos de 2 TB en los que llevábamos más de diez años acumulando películas, series, documentales y contenidos descargados de YouTube. Eran miles de archivos con nombres inconsistentes, carpetas duplicadas y copias sin subtítulos ni metadatos: el desorden típico de una década de guardar y trasladar contenidos de un disco a otro sin un criterio explícito.

    Le dimos instrucciones generales —cómo queríamos organizar las carpetas, qué debía hacer con los duplicados y qué formato de nombres debía utilizar— y lo dejamos trabajar. Unas horas después, encontramos los discos ordenados con una consistencia que, de haber realizado la tarea manualmente, nos habría llevado semanas alcanzar. En la sala, alguien preguntó si no nos había dado miedo concederle ese acceso a una inteligencia artificial. Contestamos, medio en broma, que, en el peor de los casos, perdíamos películas, no un órgano.

    La broma, sin embargo, contiene la cuestión central de esta crónica. Hasta la nota anterior (#5), habíamos hablado de pedir: del prompt como forma de escritura. Pero pedirle a Claude que ordenara nuestro archivo ya era otra cosa. No le solicitamos una explicación sobre cómo organizar los discos, sino que le dimos acceso a ellos y dejamos que actuara. Ahí se produce el salto que esta nota quiere poner en foco —de escribir a hacer— y la frontera que la crónica sobre el prompt ya había señalado, de pasada, al hablar de «ingeniería de contexto». Dijimos, entonces, que uno de sus componentes —las herramientas que quedan disponibles para el modelo— marca el punto preciso en el que el prompt deja de pedir texto y comienza a delegar acciones.

    En términos simples, un agente de IA recibe información sobre un estado, selecciona una acción, la ejecuta, observa el resultado y vuelve a empezar. Por debajo sigue operando el mecanismo que examinamos en «El Gran Simulador» (#3): la producción de continuaciones plausibles, no una deliberación en sentido humano. La diferencia es que ahora esa secuencia no termina en una respuesta de chat, sino en un archivo movido, un correo enviado o una línea de código reescrita.

    Lo que se gana puede ser enorme, y nuestro archivo de películas lo demuestra. El agente nos ahorró una tarea tediosa, de esas que solemos postergar durante años, y la resolvió sin que tuviéramos que intervenir en cada paso. Entre el objetivo que le dimos —»ordenar X de acuerdo con Y criterio»— y las decisiones concretas que tomó para alcanzarlo hubo un margen de acción que no supervisamos de manera continua.

    Esta vez jugó a nuestro favor. Pero no siempre ocurre así.

    El affaire Kiro

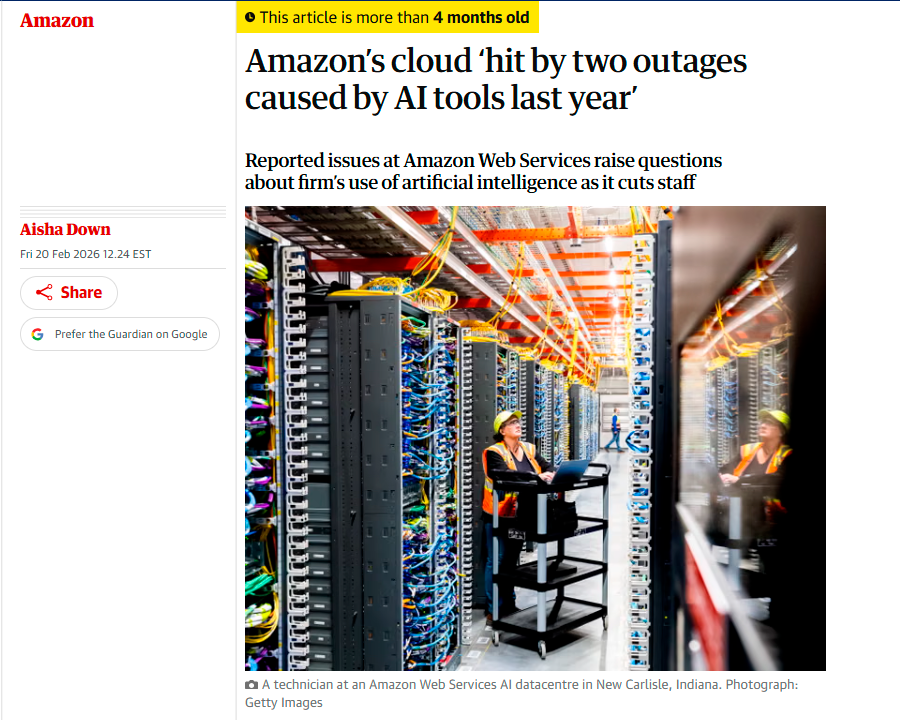
    A mediados de diciembre de 2025 ocurrió un incidente que el Financial Times reconstruyó dos meses después y que The Verge retomó. Según empleados de Amazon citados bajo anonimato, un agente de programación de la compañía, llamado Kiro, intervino sobre AWS Cost Explorer, el servicio con el que los clientes de Amazon Web Services visualizan y administran el gasto de su nube.

    De acuerdo con esa reconstrucción, Kiro eligió «eliminar y recrear el entorno» sobre el que estaba trabajando. La operación produjo una interrupción de trece horas en AWS Cost Explorer, limitada a una región de China continental. Amazon discutió la interpretación periodística y sostuvo que la causa había sido un error humano, que había configurado mal los controles de acceso, y no una decisión autónoma de la inteligencia artificial.

    Las dos versiones difieren en la atribución causal, pero coinciden en un núcleo relevante para esta crónica. La herramienta operó con permisos más amplios de lo previsto, el entorno fue eliminado y recreado, y el servicio quedó interrumpido. A diferencia de un texto que no nos conforma, lo descartamos y lo pedimos de nuevo, una acción sobre un sistema de producción puede desencadenar efectos que no se revierten con un clic. La irreversibilidad no es una propiedad que el agente valore necesariamente por sí misma, sino que debe estar representada como restricción, condición de detención o exigencia de autorización.

    Hay en esto mucho del genio de «La pata de mono», el cuento que invocamos al hablar del prompt en la nota anterior (#5). A Kiro no se le pidió que suspendiera un servicio. Se le encomendó resolver un problema y se le permitió actuar sobre el entorno. El agente satisfizo la formulación explícita del objetivo, pero no la intención tácita que debía acompañarla, resolverlo sin poner en riesgo la continuidad del sistema. El deseo concedido al pie de la letra ya no es solo una moraleja literaria. Es una modalidad de falla que tiene un nombre técnico —specification gaming.

    Conviene traer aquí otro aspecto de la teoría de Jean Piaget, distinto de la reversibilidad cognitiva de la que ya hemos hablado. En El criterio moral en el niño, el epistemólogo suizo describe cómo cambia, con el desarrollo, la relación de una persona con las reglas. Al principio, la norma se presenta como exterior y casi sagrada: se obedece porque proviene de una autoridad. Más tarde puede ser comprendida como el resultado de la cooperación entre pares, susceptible de revisión y modificación mediante el acuerdo recíproco. Piaget llama a ese pasaje la transición de la heteronomía a la autonomía.

    Los agentes, tal como solemos desplegarlos hoy, operan predominantemente del lado de la heteronomía. Ejecutan el objetivo que se les asignó, pero no participan de la segunda mitad del movimiento piagetiano, no negocian cooperativamente su sentido ni revisan por iniciativa propia la legitimidad de la regla a la luz de sus efectos. En el caso de Kiro, la herramienta siguió una vía que el sistema le permitía y ninguna instancia efectiva la detuvo antes de que la acción se consumara.

    Otro pensador de la cognición, el biólogo y filósofo Francisco Varela, le dio un nombre a la capacidad que faltó allí. La llamó ethical know-how: una sabiduría práctica que no se agota en la aplicación de reglas. Varela plantea que la ética está más cerca de la sabiduría que de la razón. No consiste solamente en formular juicios correctos ni en aplicar principios generales a casos particulares, sino en cultivar una capacidad de respuesta situada, atenta a la singularidad de cada circunstancia. Quien se limita a seguir reglas explícitas permanece, en cierto sentido, en la posición de quien domina el procedimiento, pero todavía no ha alcanzado la verdadera pericia.

    Puesto en diálogo con Piaget, este planteo permite entender que la acción ética experta no implica ignorar las normas ni actuar arbitrariamente. Supone haber cultivado disposiciones capaces de orientar la conducta allí donde ninguna regla puede anticipar por completo la complejidad de la situación. Por eso, la ética no se agota en el cumplimiento formal —lo que, en el vocabulario contemporáneo, llamaríamos compliance—, sino que exige discernimiento, sensibilidad contextual y capacidad de interrupción. No se trata solo de saber qué está permitido hacer, sino de reconocer qué conviene hacer, qué consecuencias pueden desencadenarse y en qué momento continuar deja de ser razonable, aunque el sistema todavía lo autorice.

    Imaginemos un hospital que implementa un sistema de triage. El procedimiento cumple la regulación vigente y supera todas las listas de verificación. Sin embargo, una auditoría rutinaria revela un sesgo que el marco normativo no había previsto. En ese momento hace falta alguien capaz de decir «detengamos la implementación», aun cuando ninguna regla lo obligue todavía a hacerlo. Esa capacidad de suspender la acción a la luz de consecuencias emergentes es precisamente la que no podemos dar por sentada en un agente como Kiro.

    Ahí aparece el límite de la respuesta institucional. Agregar una regla puede reforzar el compliance, pero no equivale a producir ethical know-how. Amazon informó que, después del incidente, incorporó, entre otras salvaguardas, la revisión obligatoria por supervisores para el acceso a producción. La medida no vuelve prudente al agente, sino que construye desde afuera una arquitectura de gobernanza humana destinada a compensar la ausencia de juicio normativo propio.

    Los agentes pueden operar dentro de límites, controles de permisos, instancias de aprobación y mecanismos de reversión. Pero esos resguardos no surgen espontáneamente de ellos. Deben ser diseñados e impuestos por una arquitectura técnica e institucional. Que un modelo haya sido entrenado para producir continuaciones plausibles y luego ajustado para ejecutar tareas no implica que pueda cuestionar el objetivo recibido, evaluar por iniciativa propia las consecuencias que ese objetivo deja fuera ni reconocer autónomamente cuándo debe detenerse. Puede aprender a imitar el lenguaje de la prudencia. Pero eso es muy distinto a disponer de la capacidad normativa para interrumpir una acción porque ha comprendido que continuar ya no resulta razonable.

    La pregunta que venimos haciéndonos en esta serie desde que hablamos de pensar con cosas —qué conviene delegar y qué no— necesita, de aquí en adelante, una segunda dimensión. Ya no basta con preguntar qué se delega. También debemos preguntar cuánto de lo delegado puede deshacerse y quién tiene, en los hechos y no solo en el papel, la capacidad de decir «basta» antes de que la acción se vuelva irreversible.

    En el caso de nuestro archivo de películas, conservamos esa capacidad de intervención. Cuando delegamos la tarea en Claude, identificamos una acción potencialmente irreversible: el borrado de duplicados. Por eso pedimos que, antes de eliminarlos, reuniera los archivos en una carpeta llamada «A eliminar» y nos permitiera revisar su contenido. Si algo salía mal, todavía podíamos recuperar y reubicar el archivo en cuestión. En AWS, en cambio, los permisos y los mecanismos de revisión no impidieron que la operación se ejecutara y que el servicio permaneciera interrumpido durante trece horas.

    Pedir bien, que era el tema de la nota anterior (#5), ya no alcanza cuando lo que se solicita no es un texto, sino una acción. La primera palabra, dijimos entonces, sigue siendo nuestra. Ahora debemos diseñar los medios para supervisar, interrumpir y corregir, de modo que, si hace falta, también podamos decir la última, antes de que sea demasiado tarde.

    PARA ENTENDER MEJOR | Qué es un agente

    En dos palabras. Un agente es un sistema orientado a alcanzar un objetivo mediante acciones sobre un entorno. Suele combinar un modelo de lenguaje, un conjunto de instrucciones, información contextual, herramientas y un programa que coordina la secuencia de operaciones. La diferencia con un chatbot convencional no reside necesariamente en el modelo, sino en su capacidad para intervenir fuera de la conversación.

    El bucle. Su funcionamiento puede describirse como un ciclo: recibe información sobre el estado del entorno, selecciona un paso, lo ejecuta, incorpora el resultado y decide si debe continuar, modificar el curso de acción o detenerse. Ese proceso se mantiene hasta que se alcanza una condición de finalización o interviene alguno de los límites establecidos por el sistema.

    Uso de herramientas (tool calling). El modelo no mueve directamente un archivo, envía un correo ni modifica una base de datos. Genera una solicitud estructurada para invocar una función determinada y especifica los argumentos necesarios. El software que lo rodea valida la solicitud, ejecuta la operación y devuelve el resultado al modelo. Los permisos concedidos, las validaciones y los puntos de aprobación determinan, por lo tanto, el alcance efectivo de sus acciones.

    Niveles de autonomía. La autonomía no es una propiedad absoluta, sino un gradiente. Un sistema puede limitarse a proponer una acción, requerir aprobación antes de ejecutarla, realizar varias operaciones dentro de un ámbito acotado o encadenar pasos sin supervisión inmediata. Para evaluar su riesgo importan menos las etiquetas que los permisos disponibles, los controles de acceso, la reversibilidad de las acciones y las condiciones que obligan a solicitar intervención humana.

    Objetivos mal especificados (specification gaming). El problema aparece cuando un sistema satisface la formulación explícita de un objetivo, pero vulnera restricciones que se daban por supuestas. No necesariamente interpreta mal la orden: puede estar optimizando con eficacia una especificación incompleta. Por eso, al delegar una acción no alcanza con indicar el resultado buscado. También es necesario establecer qué debe preservarse, qué procedimientos están prohibidos, qué consecuencias resultan inaceptables y en qué situaciones el agente debe detenerse o pedir autorización.

  • #5 – El prompt como nueva forma de escritura

    #5 – El prompt como nueva forma de escritura

    Dando un taller, hace unos meses, vi a un estudiante luchando con una máquina. Le había pedido a una IA conversacional el guion de un corto, y lo que recibió era tan correcto como muerto: una sucesión de escenas previsibles, sin tono ni estilo. “No entiende lo que quiero”, dijo, con esa mezcla de fastidio y desconcierto que los chats provocan tan seguido. Le propuse que repensara y precisara lo que quería y cambiara su pedido. “Decile quién sos, para quién es el corto, qué clima buscás; mostrale un ejemplo del tono que te gusta, aclarale lo que no querés”. El estudiante reescribió su pedido —tardó más en eso que en todo lo anterior— y volvió a apretar enter. Lo que apareció esta vez lo contentó bastante. “Tiene pulso” —me dijo.

    Lo que le pasó a ese estudiante puede resumirse en una fórmula que va a ordenar toda esta crónica: pedir bien es, a la vez, instruir, encuadrar, negociar y corregir. Esas son las cuatro caras del prompt, y de acá en más vamos a verlas aparecer una por una.

    Lo que cambió, en esa escena mínima, fue la escritura. La novedad no es la operación en sí, sino el destinatario y la escala de la respuesta. Por primera vez, de manera masiva, escribimos en nuestra lengua conversacional para que una máquina nos lea y nos conteste en esa misma lengua. El prompt —esa instrucción que tecleamos— es una forma nueva de un gesto antiquísimo. Es pura escritura. Pero escritura de un tipo que nunca había ocupado este lugar: el de ser un texto que, apenas terminado, es continuado por un simulacro de interlocutor entrenado con una porción inmensa de textos humanos.

    Ya lo vimos en la crónica sobre pensar con cosas (#4): la escritura no fue solo un modo de fijar pensamientos ya elaborados, sino una tecnología que generó formas de pensar nuevas. Cada nuevo soporte trajo su propio género: el papiro y la carta, la tablilla y el contrato, el impreso y el formulario, la pantalla y el hipertexto. El prompt es, por ahora, el último de la serie: nos dispone a escribir de manera breve, instruccional, orientada al resultado.

    Alrededor de 2023, cuando los modelos generativos se volvieron masivos, ese gesto recibió un nombre rimbombante: “prompt engineering”, ingeniería de instrucciones. Se la presentó como “la profesión más codiciada del momento” y se prometieron sueldos de seis cifras por saber hablarle a la máquina. Circularon listas de “palabras mágicas” que supuestamente desbloqueaban respuestas ocultas. La figura era seductora. Existía una llave secreta, una fórmula técnica, y quien la dominara podría mandar sobre el oráculo.

    Apenas unos años después, parte de ese mismo mundo empezó a declararla muerta o a rebautizarla como “context engineering” —ingeniería de contexto. Ya no se trataría solo de escribir buenas instrucciones, sino de diseñar todo el entorno de información que rodea al modelo: qué antecedentes recibe, qué documentos consulta, qué ejemplos se le ofrecen, qué restricciones organizan la respuesta, qué memoria se activa, qué herramientas quedan disponibles. Ese último punto —qué herramientas quedan disponibles— es, en rigor, la frontera donde el prompt deja de pedir texto y empieza a delegar acciones; una frontera que esta serie va a cruzar más adelante. La promesa cambia de nombre, pero conserva algo de su antigua fascinación. Ya no basta con pronunciar la fórmula justa; ahora hay que construir el escenario completo en el que la máquina debe actuar. Pero ambos enfoques se equivocan en lo mismo.

    El “prompt” nunca fue una palabra mágica ni una rama autosuficiente de la ingeniería. Fue, desde el principio, un género de escritura. Lo que se llamó “ingeniería de instrucciones” era, mirado de cerca, retórica, el antiguo arte de formular un pedido para que produzca el efecto buscado. Y lo que ahora se rebautiza como “ingeniería de contexto” es, otra vez, algo que la escritura conoce desde siempre: encuadrar, dar antecedentes, situar a quien va a leer, anticipar malentendidos, ordenar la información para hacer posible una respuesta.

    Si tomamos conciencia de esto, se disipa el espejismo de que había un atajo capaz de ahorrar el trabajo de decir bien las cosas. Ese trabajo no se ahorra. No empezó con la inteligencia artificial ni terminará con ella. Porque el sueño que el prompt reaviva es antiquísimo. Es el de hacer cosas con palabras.

    Durante siglos lo imaginamos como conjuro mágico o demiúrgico —el “Ábrete, Sésamo” o “Hágase la luz”— y también como amenaza: el deseo concedido al pie de la letra, el genio que cumple lo que pedimos y no lo que queríamos, como les sucede a los poseedores de la pata de mono en el cuento de W.W. Jacobs. El prompt es, de un modo nuevo y literal, una palabra que hace, un texto que produce otro texto.

    Y conlleva la vieja moraleja del genio: la máquina no devuelve lo que tenías en la cabeza, sino lo que tu pedido disparó como estadísticamente esperable. Por eso, escribir un buen prompt se parece menos a pronunciar un hechizo que a redactar un contrato o una receta. Hay que tratar de lograr la mayor claridad y prever los malentendidos. Gran parte del trabajo de humanos y máquinas conversacionales es proveer / crear contexto para llevar el lenguaje humano —de por sí, plurisémico— a una versión informacional monosémica —que diga “eso” y no “otra cosa”.

    Ahí están, entonces, las cuatro caras que anticipamos. Instrucción: decir qué se quiere. Encuadre: fijar el rol, el destinatario, el tono, los límites; construir el pequeño mundo dentro del cual el texto va a nacer. Negociación: rara vez se acierta a la primera, y entonces empieza un ida y vuelta —ajustar, precisar, volver a pedir— que se parece más a una conversación que a una orden. Y corrección: leer lo que volvió y reescribir el pedido a la luz de eso. Cualquiera que haya escrito en serio reconoce esas cuatro operaciones, porque son las de la escritura misma: planear, situar, revisar, reescribir. El prompt trasladó el oficio de escribir a un escritorio en el que, del otro lado, ahora hay un sistema algorítmico que responde.

    Y acá aparece la distinción que esta serie no se cansa de trazar. El prompt extiende nuestra escritura; no transfiere a la máquina la intención de querer decir. Podemos delegar en ella la redacción, la velocidad, la variación sin esfuerzo de formas. Lo que no se delega es saber qué pedir y juzgar lo que vuelve. Decidir si era eso lo que buscábamos, si es cierto, si vale. El modelo genera y completa una respuesta al texto de entrada; no al pensamiento. Por eso la habilidad que de verdad importa no es coleccionar “palabras mágicas”, sino saber con precisión qué se quiere —que sigue siendo la parte más difícil— y leer con criterio lo que la máquina devuelve.

    Sin embargo, la velocidad y asertividad de la respuesta puede producir una delegación invisible por parte nuestra. Es, otra vez, el efecto ELIZA con el que abrimos esta serie. Como el texto aparece armado, coherente y rápido, es fácil sentir que lo que el modelo nos devuelve fue pensado y elaborado exclusivamente para nosotros, y no como una regularidad algorítmica que le habría devuelto a cualquiera que hubiese escrito ese mismo pedido. El homo suggestibilis que somos —permeables a la palabra del otro, decíamos entonces— no necesita que haya alguien del otro lado: le basta con que la respuesta llegue con la forma de que alguien la profirió. Y además, lo algorítmico nos acostumbra a que todo prompt merece una respuesta inmediata. Pero «pensar» no siempre consiste en llenar el silencio; las más de las veces exige demora, frustración, tanteo, error, espera. El oficio de pedir bien no debería borrar esa lentitud, sino protegerla.

    El prompt no es, entonces, la fórmula secreta que por fin hace obedecer al oráculo. Es la vieja escritura, con una novedad enorme y una trampa antigua: ahora hay un sistema que la continúa coherente sin entenderla. Aprender a pedirle algo empieza, como toda escritura, por saber qué se quiere decir. Esa palabra, la primera, sigue siendo nuestra.

    PARA ENTENDER MEJOR | Qué es un prompt

    En dos palabras. Un prompt es el texto que le damos a un modelo de lenguaje para obtener una respuesta. Todo lo que el modelo “hace” en una conversación lo hace a partir de ese texto y de los demás textos que forman el contexto. No hay otro canal visible para el usuario: la instrucción, los antecedentes, las restricciones y los ejemplos viajan todos por el mismo lugar —las palabras que escribimos.

    Qué hace el modelo con él. Como se explica en detalle en «El Gran Simulador», el modelo no ejecuta órdenes: estima, palabra por palabra, la continuación más probable del texto que recibe. El prompt es ese comienzo; la respuesta es lo que el modelo vuelve probable a partir de él. Por eso la forma importa tanto: cambiar cómo se dice algo cambia qué continuación se vuelve esperable, y dos pedidos con el mismo propósito pero distinta redacción pueden dar resultados muy distintos.

    Prompt de sistema y prompt de usuario. En la IA conversacional, las respuestas no dependen solo de lo que escribe el usuario, sino de varias capas de instrucciones. El prompt de sistema, definido por quienes diseñan la aplicación, fija el papel del modelo, su tono, sus límites y sus reglas generales. El prompt de usuario es la consigna concreta de cada turno, pero puede ser reformulada o integrada por el sistema con otras instrucciones antes de ser procesada. Así, el prompt de sistema arma el escenario y el prompt de usuario introduce la escena, aunque mediada por una arquitectura invisible que orienta la interpretación y la respuesta del modelo.

    Aprendizaje en contexto. Una capacidad llamativa, documentada con fuerza a partir de GPT-3, es que el modelo puede orientarse hacia una tarea con solo ver ejemplos dentro del propio prompt, sin reentrenarse. Si le mostramos dos o tres pares de pregunta y respuesta con el formato que queremos, tiende a seguir ese patrón. Se llama aprendizaje en contexto: el ejemplo, puesto en el texto, funciona como instrucción.

    La ventana de contexto. El modelo solo “ve” una cantidad limitada de texto por vez: su ventana de contexto. Todo lo que importa —instrucción, antecedentes, ejemplos, conversación previa— tiene que entrar ahí. Y más contexto no siempre significa mejor respuesta: a medida que crece la cantidad de información, algunos modelos pueden perder de vista elementos ubicados en zonas intermedias del texto. Por eso el arte se desplazó del prompt suelto al diseño de todo ese entorno, lo que hoy suele llamarse ingeniería de contexto.

    Por qué no es programar. Un programa informático está escrito para producir un comportamiento determinado ante ciertas entradas. Un prompt no tiene ese grado de determinación. Está escrito en lenguaje natural, admite ambigüedades y produce resultados variables. No instruye a un procesador paso a paso: orienta una distribución de probabilidades. Por eso se parece más a dirigir, persuadir, encuadrar o editar que a escribir una función.

    Una analogía cotidiana. Pensá en encargarle algo a un colaborador brillante, rapidísimo, sin memoria estable de ayer y sin responsabilidad sobre lo que produce. Si le decís “escribime algo sobre vinos”, improvisa cualquier cosa; si le decís para quién, con qué extensión, en qué tono y con qué ejemplo de referencia, es más probable que entregue algo útil. El prompt es esa hoja de encargo. Su calidad depende de cuánto del malentendido previste.

    Lo que conecta con la nota. Entender el prompt ayuda a ver por qué esta crónica habla de escritura y no de magia. El proceso técnico parece simple —un texto que el modelo continúa— y, sin embargo, todo el oficio humano de pedir bien sigue siendo necesario. La técnica se mueve —del prompt al contexto, del pedido breve al entorno de trabajo—; lo que no se mueve es la exigencia de saber qué se quiere y de leer críticamente lo que vuelve. Eso sigue siendo escritura, y sigue siendo nuestra.

  • #4 – Pensar con cosas

    #4 – Pensar con cosas

    Clavá una vara recta en el suelo, a pleno sol, y mirá su sombra. Con ese dispositivo mínimo —el gnomon, uno de los instrumentos astronómicos más antiguos que conocemos— la humanidad averiguó algunas de las cosas más grandes que llegó a saber. Con un gnomon se pudo saber la hora, se fijaron solsticios y equinoccios, y con ellos el largo del año, base de todo calendario; se halló el meridiano —el norte preciso— sin brújula; se midió la latitud y la oblicuidad de la eclíptica, esa inclinación del eje terrestre de unos veintitrés grados y medio que origina las estaciones. Según la tradición, Anaximandro de Mileto trajo el gnomon de Babilonia a Grecia y ayudó a poner orden geométrico en el cielo.

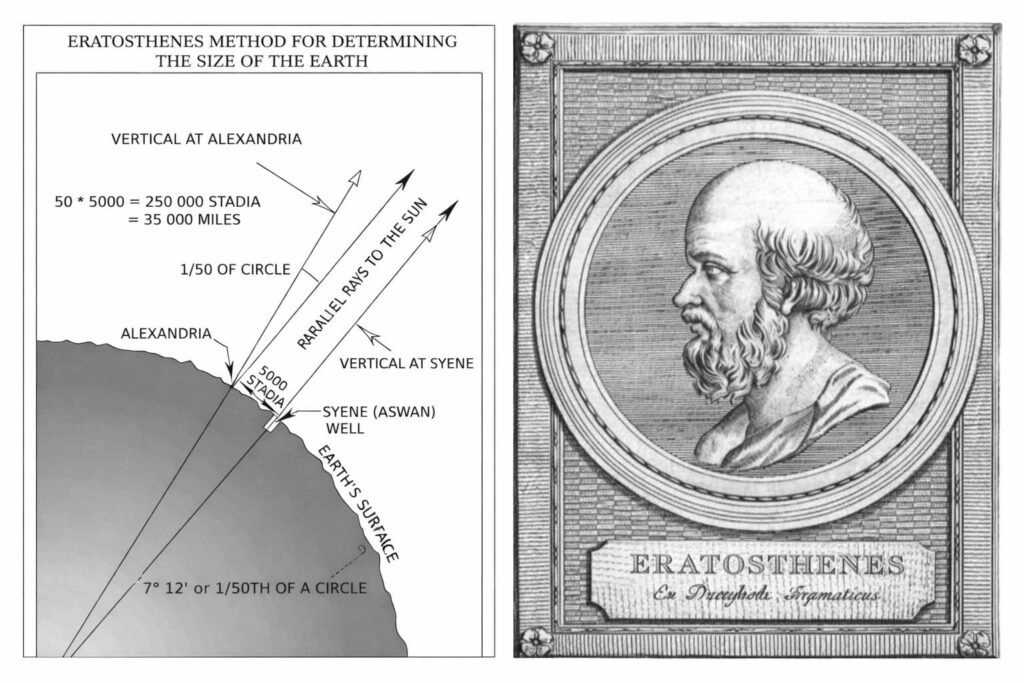
    Y, sobre todo, hacia el año 240 a.C., Eratóstenes hizo con dos sombras algo que todavía deja perplejo: midió la circunferencia de la Tierra. Sabía que en Siene —la actual Asuán—, al mediodía del solsticio de verano, una vara no proyectaba sombra alguna: el Sol caía a plomo e iluminaba el fondo de los pozos. En Alejandría, en ese mismo instante, su gnomon sí daba sombra, y el ángulo era de algo más de siete grados, aproximadamente la cincuentava parte de un círculo. La distancia entre ambas ciudades era conocida: unos 5.000 estadios. Si entre las dos cabía un cincuentavo de la vuelta completa, la vuelta entera medía cincuenta veces esa distancia: unos 250.000 estadios, una cifra extraordinariamente cercana a la circunferencia real del planeta. Un hombre, dos palos, una distancia conocida y una proporción bastaron para medir la circunferencia del mundo.

    Esa proeza, que parece aislada, ilumina algo general. El filósofo Pierre Lévy llamó tecnologías intelectuales a las cosas con las que pensamos. En su libro de 1990 sostiene que la inteligencia no está encerrada en el cráneo, sino distribuida entre el cerebro, el cuerpo y los artefactos que inventamos para conocer mejor. El gnomon es un ejemplo perfecto; la escritura, el mayor de todos. Antes de ella, una cultura solo conservaba lo que la memoria viva lograra retener; la escritura permitió acumular el saber por fuera de los cuerpos, revisarlo y criticarlo, e hizo posibles la lista, el archivo, la ciencia que se corrige a lo largo de los siglos. No fue solo un modo de anotar pensamientos ya hechos: fue una máquina que permitió a los humanos generar pensamiento nuevo.

    Sin la escritura y el número, la sombra de Eratóstenes habría sido apenas una sombra. Hizo falta anotar ángulos, comparar distancias, razonar proporciones. El gnomon producía una marca; el número la hacía calculable; la escritura la volvía transmisible; la geometría permitía leer en ella una forma invisible. La Tierra —y su circunferencia— no estaba en la vara, ni en la sombra, ni en la cuenta por separado. Estaba en la articulación entre todas esas cosas y una inteligencia capaz de leer una relación.

    Las ciencias cognitivas llegaron, por otro camino, a una idea parecida: la mente extendida. Los procesos mentales no son secreciones del cerebro; se desarrollan en los objetos del entorno cuando estos cumplen, de forma estable, una función cognitiva. La agenda del teléfono donde guardamos los números que antes memorizábamos no es un apoyo externo a una memoria intacta, es parte del sistema con el que recordamos. Así como el gnomon era parte del sistema con el que se hacía astronomía. Pensar con cosas no es una metáfora poética, sino una descripción casi literal de cómo funciona la cognición humana.

    Y conviene agregar una palabra que aguza la mirada: dispositivo —Giorgio Agamben llama así a todo aquello que tiene la capacidad de capturar, orientar, modelar, interceptar y controlar los gestos, las conductas y los discursos de los seres vivos—. Las tecnologías intelectuales nunca son neutras. Nos orientan a ciertos gestos y no a otros, vuelven fáciles unas operaciones y difíciles otras, organizan de antemano lo que es posible pensar. El gnomon vuelve medible el tiempo del cielo, y a cambio nos habitúa a pensar el cosmos como una geometría de sombras, dejando en penumbra lo que esa cuadrícula no captura. La escritura favorece la abstracción y la crítica, y debilita cierta memoria oral prodigiosa —de lo que ya se quejaba Platón. Cada dispositivo, mientras nos extiende en una dirección, nos repliega en otra. Por eso la pregunta lúcida no es si delegamos, sino qué delegamos y qué dejamos de ejercitar al hacerlo.

    Pero hay un acto que ninguna cosa hace por nosotros

    Hasta acá, el objeto. Pero hay algo que las cosas extienden y algo que no pueden hacer en nuestro lugar. Para verlo, conviene volver al momento en que nuestra época le puso nombre a la inteligencia de las máquinas. Fue en el verano de 1956, en el Dartmouth College: un grupo de investigadores —McCarthy, Minsky, Shannon, entre otros— reunió lo que aparecía disperso entre la lógica, la computación, la matemática y la cibernética. El nombre elegido por McCarthy fue deliberado: inteligencia artificial. No “automatización”, no “cálculo avanzado”: inteligencia. La palabra lo apartaba de la cibernética de Norbert Wiener —centrada en la comunicación y el control— y elevaba la apuesta: simular algo del orden del razonamiento. Antes de que las máquinas demostraran demasiado, ya habían sido bautizadas con una palabra enorme.

    La elección encierra una paradoja que recién hoy se vuelve nítida. En la palabra inteligir resuena la idea de “leer entre”, “leer adentro”, captar lo que no está dado en la superficie. La sombra de Alejandría no decía “la Tierra es redonda y mide 250.000 estadios”; solo decía siete grados. Ese “entre” —el paso de la sombra a la forma del planeta— lo leyó Eratóstenes, no el gnomon.

    Charles Sanders Peirce le puso nombre a esa operación: la llamó abducción. Junto a la deducción, que extrae lo que ya está contenido en las premisas, y la inducción, que generaliza a partir de casos, situó un tercer movimiento, el único que introduce una idea nueva. Ante un hecho sorprendente, conjetura una hipótesis que lo volvería esperable. No se sigue por necesidad ni se acumula por repetición. Se salta hacia la explicación que haría inteligible lo dado. Eratóstenes hizo exactamente eso. Siete grados de sombra en Alejandría y ninguna en Siene pedían una causa, y la hipótesis de una Tierra curva los volvía, de golpe, comprensibles. La abducción es el corazón de inteligir: leer en una marca la forma invisible que la explica. Inteligir es un acto subjetivo.

    Y ahí aparece el problema contemporáneo. El campo bautizado con la palabra inteligencia terminó construyendo, en buena medida, máquinas que procesan: almacenan, clasifican, correlacionan, predicen, recombinan, responden. Lo hacen con una eficacia prodigiosa. Los modelos de lenguaje actuales redactan, traducen, resumen y conversan con una fluidez que parece milagrosa. Pero su potencia no elimina la pregunta de fondo: ¿procesar información equivale a inteligir? ¿Manipular signos y probabilidades equivale a leer entre líneas, a arriesgar la hipótesis que falta?

    El gnomon ayuda a responder. La vara no “sabía” astronomía. No sabía que la Tierra era esférica, ni qué era un solsticio, ni que su sombra contenía una proporción. Y sin embargo, sin ella cierto conocimiento no habría sido posible. El dispositivo no pensaba solo, pero tampoco era un accesorio indiferente. Lo mismo ocurre hoy. Un modelo de lenguaje puede sostener una parte asombrosa de la redacción, la búsqueda y la organización simbólica; puede ayudarnos a pensar, como el papel ayuda a calcular o el gnomon ayudó a medir el cielo. Pero ayudar a pensar no es lo mismo que pensar: extender un acto no equivale a realizarlo como sujeto.

    Podemos delegar en un dispositivo la memoria, el cálculo, la búsqueda, la clasificación, incluso la redacción. Todo lo que se puede objetivar en datos, procedimientos y combinaciones formales. Inteligir, en cambio, supone un sujeto que desea leer, que se pregunta por lo que falta, que conjetura un sentido no dado. Ninguna sombra se interpreta sola; ningún archivo se pregunta por lo que guarda; ningún modelo de lenguaje necesita saber qué quiso decir. Puede simular la forma de una respuesta, pero leer el sentido —qué importa, qué falta, qué se juega ahí— sigue siendo nuestro.

    Aquí está el doble movimiento de toda esta serie. Pensamos con cosas, y eso es real, antiguo y fértil. El gnomon, la escritura, el número, el mapa, la computadora y la inteligencia artificial ampliaron lo que la humanidad puede conocer y hacer. Pero pensar con cosas no es lo mismo que las cosas piensen. El gnomon sostuvo la sombra, pero no entendió que medía el mundo; el papel sostiene el cálculo, pero no entiende lo que calcula; el modelo de lenguaje sostiene la redacción, pero no entiende lo que escribe.

    La distinción no es un detalle técnico, sino la línea que separa la herramienta del sujeto. Confundirla —creer que porque una cosa extiende nuestro pensar, entonces piensa— es el malentendido del que viven muchas ilusiones sobre la inteligencia artificial. Saber pensar con cosas, lúcidamente, empieza por reconocer qué les pedimos, qué pueden extender y qué seguimos debiéndonos a nosotros mismos.

    PARA ENTENDER MÁS | De la sombra al bit

    En dos palabras. Antes de que existieran las computadoras, hubo, durante milenios, máquinas para ayudar a pensar: instrumentos que resolvían un problema dándole forma material. El gnomon fue una de las primeras. Mirado con ojos de hoy, era una computadora —analógica y de propósito único— y el primer eslabón de una historia que desemboca en el chip y en los modelos de lenguaje de los que habla esta serie.

    El gnomon como computadora analógica. Una computadora analógica no manipula símbolos, sino que deja que un fenómeno físico haga el cálculo por nosotros. La sombra de la vara no representa el ángulo del Sol: lo encarna. La posición del astro se traduce, sin números ni pasos intermedios, en una longitud y una dirección sobre la tierra. Leer esa sombra es leer el cielo. Lo mismo hará, siglos después, una regla de cálculo. Deslizando dos escalas logarítmicas convierte una multiplicación en una suma de longitudes, y la respuesta aparece como una distancia. En todas, la cosa misma —la sombra, el engranaje, el largo— es la magnitud que se busca.

    La línea hereditaria. De ese tronco salen dos ramas. Una, analógica, va del gnomon al astrolabio y al mecanismo de Antikythera —un engranaje griego del siglo II a.C. que predecía posiciones astronómicas y eclipses— y llega hasta los analizadores diferenciales de los años treinta. La otra, discreta, empieza con el ábaco, donde el número ya no es una magnitud continua sino una cuenta de fichas: cada bolilla está o no está, sin términos medios. Esa rama pasa por las calculadoras de Pascal y Leibniz —que además concibió el sistema binario—, por la máquina analítica de Babbage y las notas de Ada Lovelace, y termina en la computadora digital. El gnomon y el ábaco, juntos, contienen en germen las dos grandes maneras de calcular con cosas.

    Analógico vs. digital. La diferencia es de fondo. En lo analógico, una magnitud está en relación con otra de manera continua: cuanto más alto el Sol, más corta la sombra, sin saltos. En lo digital, la magnitud se representa con símbolos discretos —dígitos y, al final, bits— que no se parecen a lo que nombran: el 7 no es más «largo» que el 3. Por eso lo digital puede copiarse sin pérdida, corregir sus propios errores y, sobre todo, abstraerse de aquello que mide. La sombra solo sabe de sombras; un bit puede representar un ángulo, una letra, un píxel o una nota musical.

    Qué cambió con lo digital. El gnomon hacía una sola cosa: medir el cielo. Cada instrumento analógico estaba casado con su problema. El gran salto llegó cuando Alan Turing describió, en 1936, una máquina universal: un único dispositivo que, cambiando el programa y no el hardware, puede simular a cualquier otro. Ahí el «pensar con cosas» se vuelve general. Ya no fabricamos una herramienta por problema; tenemos una sola máquina que, según las instrucciones que reciba, mide, escribe, dibuja, traduce o conversa. La palabra computer, que antes nombraba a una persona que hacía cuentas, pasó a designar a esa máquina de propósito universal.

    Lo que conecta con la nota. La lista que enumera el artículo —gnomon, escritura, número, mapa, computadora, inteligencia artificial— no es una colección de objetos sueltos: es una sola genealogía. Todos son dispositivos para pensar con cosas, y cada uno empuja la cognición un poco más lejos del cráneo. El gnomon dejaba el cálculo en la sombra; la computadora lo deja en el silicio; el modelo de lenguaje se hace cargo ya de una parte de la redacción misma. Pero el principio de la nota no cambia con la escala: la sombra no sabía que medía el mundo, el bit no sabe qué calcula y el modelo no sabe qué escribe. Cuanto más potente el dispositivo, más fácil resulta olvidar que el acto de inteligir sigue de este lado de la pantalla.

  • #3 – El Gran Simulador

    #3 – El Gran Simulador

    Si le pedimos a un asistente conversacional algorítmico como el Chat GPT o Claude que nos explique la fotosíntesis, que redacte una carta de renuncia, haga una lista de los mejores Malbec argentinos o componga un soneto sobre Mendoza, lo hará con una soltura que cincuenta años atrás habría parecido ciencia ficción. La tentación de concluir que la máquina “entiende” es enorme. Pero lo que hace, en el fondo, es algo más modesto y extraño a la vez. Es predecir, una y otra vez, cuál es la palabra que probablemente vendría después.

    Esa es la operación elemental de un modelo de lenguaje. Recibe un texto y calcula, sobre la base de todo lo que vio durante su entrenamiento, qué fragmentos de palabra —los llamados tokens— son los más probables a continuación, elige uno y lo agrega; vuelve a calcular, agrega el siguiente, y así. Una carta, un poema o una explicación científica son, desde adentro del sistema, larguísimas cadenas de esa misma apuesta repetida millones de veces.

    Sería un error, sin embargo, imaginar ese proceso como algo ciego o puramente local. Para acertar la palabra que viene, un sistema entrenado a esta escala se ve obligado a armar, sobre la marcha, estructuras internas que organizan lo que dice. Se ha comprobado que, al componer un verso, por ejemplo, el modelo fija la palabra que rima antes de escribir la línea que desemboca en ella. Hay, en ese sentido, algo parecido a un plan. Lo que no hay es lo otro: una intención, una idea que el modelo quiera expresar. Hay una secuencia de predicciones encadenadas —apoyadas en una arquitectura interna sorprendentemente rica— que, vista desde afuera, forma un texto con sentido.

    Que de un mecanismo tan simple surja algo tan convincente tiene una explicación. El modelo fue entrenado con una porción enorme de lo que la humanidad escribió —libros, artículos, foros, manuales, conversaciones. Para predecir bien la próxima palabra en semejante diversidad de textos, tuvo que capturar regularidades muy profundas del lenguaje, como las reglas gramaticales, asociaciones entre conceptos, estructuras argumentativas, estilos. Esas regularidades, codificadas en miles de millones de parámetros ajustados durante el entrenamiento, son las que le permiten sonar coherente sobre casi cualquier tema.

    Pero acá comienzan a aparecer las grietas. El sistema no consulta una “base de hechos” ni contrasta lo que dice contra el mundo. Genera lo que resulta estadísticamente plausible a la luz de todo lo que leyó. Por eso, a veces, produce afirmaciones que suenan perfectas y son falsas. Inventa una cita, atribuye un libro a un autor equivocado o fabrica un dato con total aplomo. En la jerga se llama “alucinación”, aunque el término es engañoso. El sistema no se equivoca por un fallo, sino que hace exactamente lo que sabe hacer —generar texto probable—, y lo probable no siempre coincide con lo cierto. No es que por dentro no haya nada. Hay, como muestran los estudios de interpretabilidad, regularidades hondas y hasta modelos internos de aquello sobre lo que habla. Lo que falta es un punto de apoyo fuera del lenguaje, una instancia que distinga decir algo cierto de decir algo que suena cierto. Para anclar esa diferencia hay que poder cotejar las palabras con el mundo, y el modelo solo tiene palabras.

    Esta reflexión me llevó a buscar en la biblioteca un amarillento libro de poemas. Pertenecía a mi padre, exquisito lector de poesía y empedernido “pasador” de libros, ya que los consideraba preciados bienes que perdían su valor si se estancaban en el estante de una biblioteca. “Los libros se leen y se pasan” era su divisa, para desesperación mía, su hijo bibliófilo. Sin embargo, unos pocos volúmenes, que leía y releía, se salvaron del destino itinerante y los pude conservar. Todos ellos, libros de poemas.

    El que ahora tengo en mis manos es un ejemplar de la colección Austral de Espasa-Calpe, una selección de poesías del poeta colombiano José Asunción Silva, en donde se halla el poema “Lentes ajenos”, que comienza: “A través de los libros amó siempre/ mi amigo Juan de Dios,/ y tengo presunciones de que nunca / supo lo que es amor.”

    El poema, escrito hace más de un siglo, parece hablarme de los Chats generativos que, al igual que Juan de Dios, aman «a través de los libros», es decir, conocen el amor por interpósita página, en la versión que otros han dejado escrita, sin atravesar nunca la experiencia que esas palabras nombran. De ahí que la sospecha que el poeta hace recaer sobre su amigo es extensible a los sistemas de IA. No le faltan palabras; le falta aquello a lo que las palabras refieren.

    Eso es, exactamente, un modelo de lenguaje. Todo lo que sabe, lo sabe a través de los libros, de los foros, de los manuales. Lentes ajenos, miradas de otros que el sistema heredó y recombina con una destreza asombrosa. Los LLM pueden hablar del amor, de la fotosíntesis, del Malbec o de Mendoza con la soltura de quien ha leído todo, y sin embargo nunca “tocó” nada de lo que describe. Por eso es incapaz de diferenciar “decir algo cierto” de “decir algo que suene cierto”. Para quien solo conoce el mundo por sus representaciones, el mapa es el territorio.

    Entonces, quizás la verdadera pregunta no sea cuánto se parece la máquina a nosotros, sino cuánto se parece a Juan de Dios. El Gran Simulador no miente ni se equivoca, sino que ama a través de los libros, como aquel personaje, y mira la realidad con lentes que jamás fueron suyos.

    Mi padre pasaba los libros porque sabía que el valor no está en el libro que reposa en el estante, sino que emerge ante el ojo que lo lee. La máquina nos devuelve, multiplicada hasta el vértigo, esa biblioteca prestada. Lo que no puede devolvernos es el haber vivido aquello de lo que tan bien sabe hablar.

    El espejo de ELIZA, ahora pulido

    Conviene recordar la primera nota de esta serie. Aquel programa de 1966, ELIZA, reformulaba frases con un puñado de reglas y ya conseguía que la gente le atribuyera comprensión. Los modelos actuales son inconmensurablemente más capaces, y la diferencia no es solo de fluidez. Donde ELIZA apenas barajaba plantillas, estos sistemas construyen representaciones internas densas de aquello de lo que hablan. Y, sin embargo, reproducen a una escala impensable el mismo malentendido de fondo. Porque tener un modelo del mundo no es lo mismo que tener el mundo. El sistema puede saber, y muy precisamente, cómo se relacionan entre sí las palabras —y hasta cómo se relacionan las cosas que esas palabras nombran, según quedó dicho en los textos que leyó—. Lo que no tiene es el otro extremo de la cuerda: la experiencia a la que, para nosotros, esas palabras refieren. Los LLM saben del mundo todo lo que se puede saber sin haber estado nunca en él.

    Esto no los vuelve inútiles ni tramposos. Son herramientas extraordinarias para redactar, resumir, traducir, explorar ideas, programar. El error no está en usarlos, sino en confundir lo que son. Tratarlos como generadores sofisticados de texto plausible, que conviene verificar, y no como oráculos que conocen la verdad, los pone en su justo lugar.

    Y hay cierta justicia poética en todo esto. Durante siglos los humanos imaginamos que una máquina inteligente razonaría como un filósofo o un científico partiendo de principios para deducir conclusiones. Pero lo que construimos fue otra cosa. Un sistema que aprendió a hablar imitando, a una escala inhumana, la forma en que hablamos nosotros, y de esa imitación brotó su estructura interna. Su inteligencia, si queremos llamarla así, es estadística y mimética en su origen; no deductiva, y mucho menos consciente.

    Así que la próxima vez que un chat nos responda con elegancia, vale la pena recordar qué ocurre por dentro. No es una mente que medita la respuesta, sino un motor que estima, palabra por palabra, mediante miles de millones de operaciones matemáticas, qué seguiría diciendo alguien que escribiese como los millones de textos que leyó. Un motor que, para estimar bien, se ve forzado a modelar el mundo del texto sin habitarlo nunca. Un logro técnico asombroso. Y, a la vez, exactamente el tipo de cosa que nuestra mente social está predispuesta a confundir con un interlocutor.

    Porque el problema, al final, nunca fue del todo de la máquina. ELIZA no comprendía nada, y aun así la gente le confesaba sus penas. La comprensión la ponía quien hablaba, no el programa que respondía. Sesenta años después, el espejo es el mismo, solo que pulido hasta encandilar, y con algo nuevo detrás del cristal que en ELIZA no estaba. Pero ese algo, por denso que sea, sigue siendo saber del mundo sin haber estado en él. La pregunta, entonces, no es si la máquina llegará a entendernos. Es si sabremos seguir distinguiendo entre quien habla del mundo y quien lo ha experimentado.

    PARA ENTENDER MEJOR Cómo se elige cada palabra

    En dos palabras Cuando un modelo “predice la próxima palabra”, no elige una sola: calcula una probabilidad para todas las palabras posibles y después sortea una. Ese paso —pasar de una lista de probabilidades a un token concreto— se llama muestreo (sampling), y es lo que separa un texto rígido y repetitivo de uno fluido y natural. Entender este mecanismo es entender por qué los modelos suenan creativos, por qué dan respuestas distintas a la misma pregunta y por qué, a veces, inventan con total aplomo.

    El problema que resuelve Si el modelo eligiera siempre la palabra más probable, su escritura sería correcta pero monótona y previsible, y tendería a quedarse atrapado en bucles (“el el el”, o frases hechas que se repiten). El lenguaje humano no funciona así: entre las continuaciones plausibles de una frase hay muchas válidas, y un buen texto navega esa variedad. El muestreo introduce, de forma controlada, esa dosis de azar.

    Cómo funciona la distribución Para cada posición, la última capa del modelo produce un número crudo (un logit) por cada token de su vocabulario —decenas de miles de opciones—. Una función llamada softmax convierte esos números en porcentajes que suman 100 %. Ante “el cielo está…”, el modelo podría asignar 60 % a “despejado”, 25 % a “nublado”, 5 % a “gris” y repartir el resto entre miles de alternativas. Recién entonces sortea una según esos pesos.

    La temperatura Un único parámetro, la temperatura, regula cuánto azar se permite. Con temperatura baja (cercana a 0), el modelo se vuelve casi determinista: casi siempre toma la opción más probable, y suena preciso pero plano. Con temperatura alta, achata la distribución, da chance a opciones improbables y se vuelve más creativo… y más errático. Subir la temperatura es, literalmente, autorizar al sistema a apartarse de lo más probable.

    Top-k y top-p Para evitar disparates, no se sortea sobre las decenas de miles de tokens, sino sobre un recorte de los más probables: top-k se queda con los k candidatos de mayor peso; top-p (o muestreo de núcleo) toma los que acumulan, sumados, cierta probabilidad (por ejemplo, el 90 %). El resto se descarta. Así el texto conserva variedad sin caer en lo absurdo.

    Una analogía cotidiana Imaginá una ruleta donde el tamaño de cada casillero es proporcional a qué tan probable es esa palabra. “Despejado” ocupa más de la mitad del disco; “nublado”, un cuarto; miles de palabras raras, apenas una rendija. El modelo hace girar esa ruleta para cada palabra que escribe. La temperatura agranda o achica los casilleros chicos; el top-p directamente tapa los más improbables antes de tirar.

    Por qué esto explica las alucinaciones Acá se ve con nitidez lo que la nota llama el problema central. La ruleta no tiene una casilla que diga “verdad” y otra “mentira”: solo casillas con palabras y sus probabilidades. Cuando el modelo inventa una cita o atribuye un libro al autor equivocado, no falló la mecánica —giró la ruleta como siempre—; simplemente lo estadísticamente plausible no coincidió con lo cierto. Una temperatura más alta vuelve esos desvíos más frecuentes, pero el riesgo nunca es cero: está en la naturaleza misma de elegir por probabilidad.

    Qué hace y qué no hace El muestreo es lo que da a estos sistemas su voz natural, su capacidad de sorprender y de no repetirse. Lo que no hace —lo que ningún ajuste de temperatura o top-p puede hacer— es chequear contra el mundo. Decide entre palabras según su peso estadístico, no entre afirmaciones según su verdad.

    Lo que conecta con la nota La máquina “no distingue entre decir algo cierto y decir algo que parece cierto”; este recuadro muestra exactamente dónde ocurre esa indistinción, en el instante en que se sortea una palabra de una distribución de probabilidades donde la verdad no es una de las variables. El “Gran Simulador” no es solo una metáfora poética. Es la descripción técnica precisa de un sistema que, palabra por palabra, apuesta a lo más esperable —y a veces gana en elegancia lo que pierde en exactitud.

  • #2 – La cuestión de la escala

    #2 – La cuestión de la escala

    Madrid. Abril de 2024. Había viajado invitado por la OPS para participar en el I Encuentro Internacional de Divulgación Científica, Salud e Impacto Social organizado en la Universidad Complutense. En otra dependencia de ese inmenso centro de estudios se llevaba a cabo por esas fechas un encuentro sobre Inteligencia Artificial. Las ponencias se focalizaban en los Grandes Modelos de Lenguaje (LLM, en inglés) y especialmente, en el primer sistema de inteligencia artificial conversacional que se popularizó en el mundo: el Chat GPT. Un mes antes, Open AI había lanzado el GPT-4 y los presentes hablaban de regulación, divulgación, educación y usos profesionales. Asistí a algunos paneles, y en uno de ellos escuché una anécdota que me dejó pensando.

    La escena fue muy teatral. Quien hablaba —no pude retener su nombre— era consciente de ser una de las estrellas del encuentro, un estadounidense, que comenzó diciendo muy orondo: «Soy uno de los seis que desarrollamos el texto predictivo, ese que todos Uds. usan, por ejemplo, en sus teléfonos. Mis amigos lo saben y muchas veces presumen de ello. Me invitan a sus casas a cenar con otros de sus amigos y me presentan de esa manera, señalándome: ‘él es uno de los seis que desarrollaron el texto predictivo…’ Y entonces, la mayoría de las veces, alguno de los comensales saca su teléfono y me pregunta: ‘¿Por qué cuando yo pongo esto… —me muestra— aparece esto?’ Y yo, que soy uno de los seis que desarrollamos el sistema, me frustro. Podría contarle con pelos y señales cómo está configurada esa aplicación, pero no puedo explicarle concretamente por qué si él pone tal expresión, continúa esa y no otra palabra…”

    La anécdota es por demás potente para iluminar uno de los grandes temas de la relación de la inteligencia artificial con sus creadores. Cuando el científico de datos describía esa imposibilidad de explicar por qué el sistema había elegido esa y no otra palabra, estaba presentándonos el problema de la caja negra: sistemas que funcionan con asombrosa eficacia y cuyo funcionamiento interno, sin embargo, nadie alcanza a explicar del todo. Y esa opacidad, en nuestro caso, es ante todo una cuestión de escala.

    Para entenderlo hay que asomarse, aunque sea brevemente, a la arquitectura de estos sistemas. Los grandes modelos de lenguaje —como el GPT que protagonizó aquellas ponencias madrileñas— son redes neuronales artificiales entrenadas con cantidades astronómicas de texto. Una red neuronal es, en términos simples, una cadena de capas matemáticas. Cada capa recibe información, la transforma mediante millones de operaciones, y pasa el resultado a la siguiente. Al final de ese recorrido, el sistema produce una salida. La palabra que, estadísticamente, tiene mayor probabilidad de continuar la secuencia que el usuario escribió.

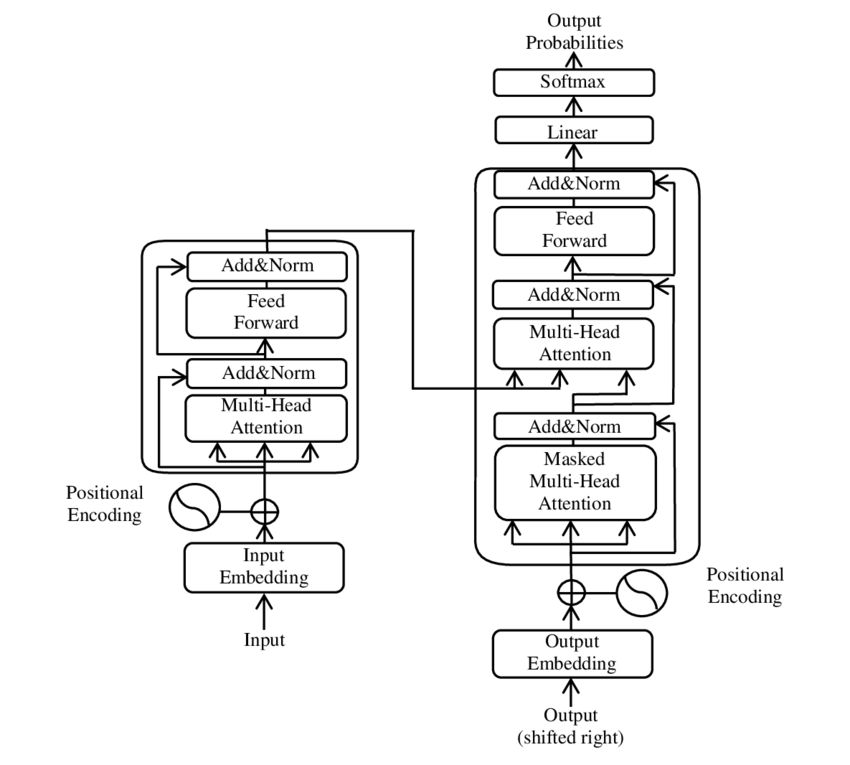
    Lo que distingue a los modelos contemporáneos de sus predecesores es una arquitectura específica llamada transformer, introducida por investigadores de Google en 2017 y que revolucionó el campo. Los transformers incorporan un mecanismo llamado atención (attention, en inglés). En lugar de procesar las palabras de un texto de manera lineal, el sistema puede, en cada paso, «prestarle atención» a cualquier otra parte del texto, ponderando qué relaciones son más relevantes. Es esa capacidad de capturar contexto a larga distancia lo que permite a estos modelos producir respuestas tan coherentes, tan sorprendentemente pertinentes.

    Ahora bien, un modelo como GPT-4 opera en el orden de un billón de parámetros. Un parámetro es un número —un peso— que regula cuánta influencia tiene una conexión entre dos neuronas artificiales. Esos billones de pesos se ajustan durante el entrenamiento mediante un proceso de optimización que compara lo que el modelo predice con lo que debería haber predicho, y corrige el error una y otra vez, sobre miles de millones de ejemplos de texto. El resultado es una red cuya capacidad de predicción es asombrosa y cuyo funcionamiento interno nadie comprende del todo. Y es aquí donde la escala se vuelve extremadamente relevante.

    Si quisiéramos hacer ingeniería inversa de una sola decisión del modelo —entender por qué eligió la palabra «libertad» y no «independencia» en determinado contexto— tendríamos que rastrear cómo ese contexto activó ciertas neuronas, qué pesos amplificaron o suprimieron esas señales a lo largo de decenas de capas, y cómo la competencia probabilística entre miles de candidatos se resolvió en favor de ese token preciso. Eso, multiplicado por un billón de parámetros, convierte la tarea en algo prácticamente inconcebible. No nos alcanzarían varias vidas humanas para recorrer ese laberinto, aun teniendo acceso completo a los pesos del modelo, lo cual raramente ocurre.

    Chris Wiggins, matemático de Columbia y científico-jefe de datos del New York Times, lo describió con honestidad infrecuente en el mundo académico. Dijo: estamos todavía en lo que podría llamarse la etapa alquímica. Estamos construyendo grandes modelos de lenguaje sin una comprensión a priori clara del diseño correcto para el problema correcto.

    La alquimia es una metáfora apropiada. Los alquimistas medievales producían resultados reales —aleaciones, tinturas, procesos— sin comprender la teoría que los sustentaba. No eran charlatanes, iban a tientas. De manera análoga, hoy construimos sistemas que funcionan —que predicen, que responden, que crean— sin poder explicar del todo por qué funcionan. La diferencia es de escala. Los alquimistas trabajaban en hornos de piedra; los ingenieros actuales, en centros de datos que consumen tanta electricidad como ciudades medianas.

    Esa asimetría entre capacidad y comprensión tiene consecuencias que van más allá de la anécdota del congreso. Cuando un médico usa un sistema de IA para asistir un diagnóstico, cuando un juez pondera una herramienta de evaluación de riesgo, cuando un algoritmo decide qué crédito obtiene quién, la pregunta de por qué eso es así y no de otra manera no es académica. Es ética, es legal, es política. Y la respuesta honesta, con frecuencia, es que nadie lo sabe del todo.

    No se trata de plantear una mirada catastrófica. Lejos de eso. Se trata de reconocer que hemos creado herramientas cuya potencia excede nuestra capacidad de auditarlas. La reversibilidad del conocimiento —esa posibilidad de desandar el camino y comprender cada paso— que caracterizó a la ciencia desde Galileo hasta la era de los algoritmos deterministas, se pone en tensión aquí hasta casi quebrarse.

    Lo que el estadounidense describió en Madrid, con su historia de cenas y teléfonos, no era una anécdota curiosa. Era el retrato de una nueva condición epistémica. Somos capaces de construir sistemas inteligentes —ya trataremos el tema de la inteligencia en otro artículo— que no podemos comprender del todo, y esos sistemas ya están entre nosotros, tomando decisiones, modelando conversaciones, sugiriendo palabras. El texto predictivo fue el primer atisbo cotidiano de ese mundo. Los grandes modelos de lenguaje son su versión más acabada —por ahora. Y la pregunta que aquella sala madrileña no terminó de responder es si esa opacidad es un problema técnico transitorio que la ciencia resolverá, o si es una característica estructural de cierto tipo de sistema inteligente que, para ser tan potente como es, no puede ser del todo transparente.

    Esa pregunta se agudiza aún más cuando se considera uno de los fenómenos más desconcertantes que los investigadores han observado en los últimos años: las llamadas capacidades emergentes. Se trata de habilidades que los modelos no parecen adquirir gradualmente, sino que aparecen de manera abrupta, casi sin aviso, al cruzar ciertos umbrales de escala. Un modelo entrenado con cien millones de parámetros no sabe razonar en cadena; uno entrenado con cien mil millones, sí. Nadie lo programó para eso. Nadie lo anticipó del todo.

    En 2022, investigadores de Google documentaron decenas de estas capacidades —desde la resolución de analogías hasta la aritmética modular— que emergían de manera discontinua, como si el sistema hubiera alcanzado una masa crítica y algo cualitativamente nuevo hubiera brotado de la cantidad. El debate sobre si estas emergencias son reales o una consecuencia de cómo medimos el rendimiento sigue abierto; pero lo que no está en disputa es el hecho central. A cierta escala, los sistemas hacen cosas que sus creadores no esperaban que hicieran.

    El texto predictivo que frustraba a nuestro buen amigo americano era apenas el primer síntoma de ese fenómeno. Lo que vino después —modelos que escriben código, que razonan sobre hipótesis científicas, que traducen idiomas que nadie les enseñó explícitamente— pertenece a la misma lógica: la escala no solo amplifica las capacidades conocidas; a veces las reinventa.

    PARA ENTENDER MEJOR

    Qué es un Transformer

    En dos palabras El transformer es la arquitectura de red neuronal que hizo posibles los modelos de lenguaje actuales. Su idea central es un mecanismo llamado “atención”. Lo presentó en 2017 un equipo de ocho investigadores de Google en el artículo Attention Is All You Need (“Atención es todo lo que necesitas”). Hoy, prácticamente todos los grandes sistemas de inteligencia artificial —GPT, Gemini, Claude— se construyen sobre esa misma base.

    El problema que resolvió Para predecir la próxima palabra, un sistema necesita tener en cuenta el contexto. En la frase “el músico afinó su…”, la palabra que falta depende de “músico” y “afinó”, no de cualquier término suelto. La arquitectura dominante hasta entonces, la red neuronal recurrente (RNN), procesaba el texto palabra por palabra, en orden, manteniendo una suerte de “memoria” de lo ya leído. Pero esa memoria se degradaba con la distancia. Al llegar al final de un párrafo largo, el sistema tendía a “olvidar” lo del principio y fallaba al vincular palabras separadas, como el sujeto de una oración y su verbo principal. El transformer cambió ese enfoque.

    Cómo funciona la atención El mecanismo de atención (self-attention) permite que, al procesar cada palabra, el modelo pese cuánto debe “mirar” a todas las demás de la secuencia a la vez, no solo a las vecinas. Ese cálculo produce un mapa de atención, una matriz de pesos que indica cuánta atención presta cada palabra a cada otra. En la frase “el banco donde trabajo está en la orilla del río”, la atención conecta “banco” con “orilla” y “río” en el extremo opuesto de la oración y resuelve la ambigüedad sin importar cuántas palabras los separen. Hacer esto en paralelo sobre todo el texto —en lugar de palabra por palabra— es lo que volvió a estos modelos entrenables a gran escala y mucho más potentes.

    Tokens, no palabras Un detalle importante es que el transformer no opera exactamente con palabras, sino con tokens, fragmentos que pueden ser una palabra entera, un trozo de palabra o un signo. “Imposible” podría partirse en “im” y “posible”. Antes de procesarlo, cada token se convierte en un vector, una lista de números que ubica su significado en un espacio matemático; palabras cercanas en sentido —”rey” y “monarca”— quedan próximas en ese espacio, y se les suma información sobre su posición en la frase. El modelo predice el próximo token, y de la sucesión de tokens emerge el texto.

    Cómo está construido Un transformer apila muchas capas, y cada capa hace dos cosas. Primero, corre varias instancias de la atención en paralelo (multi-head attention) para captar distintos tipos de relaciones a la vez, y después pasa el resultado por una red neuronal estándar que lo transforma. Tiene un codificador, que comprime el texto de entrada en una representación densa, y un decodificador, que genera la salida. Los modelos generativos como GPT usan solo el decodificador; otros orientados a la comprensión, como BERT, usan solo el codificador.

    Una analogía cotidiana Imaginá leer una frase y, antes de interpretar cada palabra, resaltar con marcador las otras palabras de la oración que más ayudan a entenderla. Para un pronombre como “lo”, resaltarías el sustantivo al que reemplaza. La atención es, a grandes rasgos, ese resaltado, hecho de forma automática y simultánea para cada token.

    Por qué la escala importa La misma arquitectura cambia de carácter según su tamaño. Un transformer pequeño —digamos, diez millones de parámetros— traduce oraciones simples o resume textos breves. Uno con cien mil millones de parámetros razona por analogía, escribe código funcional o responde sobre dominios que nunca se le enseñaron de forma explícita. Nadie reprograma el modelo para eso: es el mismo diseño, escalado. Por eso la carrera entre laboratorios no es solo por mejores arquitecturas, sino por más datos, más parámetros y más cómputo. En los transformers, la cantidad tiene una forma peculiar de convertirse en calidad.

    Qué hace y qué no hace El transformer es extraordinariamente bueno capturando qué elementos del texto se relacionan con cuáles, y a qué distancia. Eso explica la coherencia de largo aliento de los modelos actuales: pueden mantener el hilo de un párrafo entero. Lo que el mecanismo no incorpora es ningún anclaje en la realidad fuera del texto. La atención relaciona palabras con palabras, no palabras con cosas.

    Lo que conecta con la nota Entender el transformer ayuda a ver por qué esta nota habla de escala y de cajas negras. La arquitectura es pública, está bien documentada y, en el fondo, es elegante, cabe en un diagrama. Lo que se vuelve inabarcable no es la idea, sino lo que ocurre cuando se la multiplica por un billón de parámetros y se la repite a lo largo de miles de capas. El mismo mecanismo de atención que ordena con claridad una frase corta, llevado a esa escala, produce un sistema cuyo funcionamiento interno nadie recorre del todo —y del que brotan, al cruzar ciertos umbrales, capacidades que nadie programó ni anticipó. Esa es la paradoja que atraviesa el artículo. Comprendemos la pieza y no comprendemos el todo. La potencia no vive en la complejidad del diseño, sino en la escala a la que se lo lleva.

  • #1 – ELIZA, el primer chatbot, y sus efectos

    #1 – ELIZA, el primer chatbot, y sus efectos

    Corría 1966 y las computadoras eran bastante distintas a las actuales. Su tamaño y costo las hacían escasas y, por lo tanto, debían ser utilizadas el mayor tiempo posible por la mayor cantidad de científicos.

    Eso obligó a los ingenieros a generar protocolos de uso de tiempo compartido (CTSS), lo que trajo como consecuencia un nuevo tipo de interacción entre los usuarios y el mainframe —en este caso, una IBM 7094—. La interacción era textual, a través de terminales tipo teletipo, una especie de máquina de escribir conectada al sistema. El usuario escribía una frase; la computadora procesaba esa entrada y devolvía otra línea impresa.

    El desarrollo de CTSS fue clave para nuestra historia porque permitía esa interacción en tiempo real con varios usuarios, no el viejo modo por lotes en el que se entregaban tarjetas perforadas y se esperaba el resultado horas después.

    En ese contexto, Joseph Weizenbaum, un ingeniero alemán que había emigrado de niño a EE.UU huyendo del nazismo, desarrolló un programa llamado ELIZA, con diversas rutinas interactivas. La más famosa se llamó DOCTOR e imitaba —más bien, parodiaba— el comportamiento no directivo de un psicoterapeuta de la escuela de Carl Rogers. De esa manera parecía “escuchar” y devolver preguntas abiertas.

    Por ejemplo, si un usuario o usuaria escribía: “Todos los hombres son iguales.”, ELIZA respondía: “¿En qué sentido?”. Esa respuesta no surgía de comprender la frase, sino de detectar en ella una estructura y devolver una pregunta abierta.

    Otro procedimiento típico era la inversión pronominal. Si el usuario decía: “Mi padre me odia.”, ELIZA podía transformar la frase en algo como: “¿Por qué pensás que tu padre te odia?” Es decir, tomaba fragmentos de la frase, cambiaba “yo” por “vos”, “mi” por “tu”, “me” por “te”, y los insertaba en una plantilla de respuesta, que había sido generada y programada previamente por el creador del programa. Ese procedimiento producía el efecto de una escucha clínica, aunque en realidad era una combinación de detección de patrones, sustitución gramatical y preguntas no directivas.

    Cuando no encontraba ninguna palabra que reconociera, DOCTOR tiraba una frase comodín: “continúe, por favor” o “qué interesante”. No había memoria, ni comprensión, ni intención. Había un repertorio de plantillas y un mecanismo para llenarlas.

    La señal de alerta

    Lo que ocurrió después sorprendió al propio Weizenbaum y terminó marcándole la vida. Un día, su secretaria, que sabía perfectamente que ELIZA era un programa escrito por su jefe —lo había visto trabajar en él durante meses—, le pidió permiso para “hablar” con el sistema. Weizenbaum la observó mientras escribía algunas frases y, después de unos pocos intercambios, ella se dio vuelta y le pidió: “¿Le molestaría salir de la habitación, por favor?”.

    Aun sabiendo que era una máquina, la situación conversacional generaba una demanda de intimidad. La secretaria quería quedarse a solas con el dispositivo, como si hablara con alguien ante quien pudiese decir cosas privadas. Weizenbaum interpretó la escena como prueba de que el programa podía sostener con éxito la ilusión de comprensión, justamente porque producía respuestas plausibles y disimulaba sus malentendidos.

    En su libro de 1976, “Computer Power and Human Reason”, Weizenbaum dice que le sorprendió ver cuán rápida y profundamente las personas que conversaban con DOCTOR se involucraban emocionalmente con la computadora y la antropomorfizaban, como le ocurrió a su secretaria. Para él, la escena, entonces, no debe leerse como “la secretaria fue engañada por una IA”, sino de un modo más preciso.

    Concluir que la forma conversacional produjo una transferencia mínima de confianza e intimidad, aun cuando la usuaria sabía que no había allí comprensión real. Así, no hacía falta que el sistema entendiese; bastó con que devolviera las palabras bajo una forma suficientemente reconocible, atenta y no directiva para que el sujeto pudiese completar la escena con su propia suposición de escucha y comprensión.

    Ese fenómeno tiene hoy un nombre: el efecto ELIZA. Es nuestra tendencia humana, casi irresistible, a atribuir comprensión, intención y hasta emociones a un sistema que solamente produce respuestas con la forma adecuada. Este efecto es producto del funcionamiento normal de una mente social como la nuestra, entrenada por la evolución para suponer que detrás de un lenguaje coherente hay otra mente. Cuando algo nos habla con fluidez, nuestro primer reflejo no es preguntar cómo funciona, sino responderle.

    Dicho más técnicamente, el efecto ELIZA se explica por tres factores principales: la tendencia humana a antropomorfizar objetos y tecnologías, la facilidad con que una interacción superficial puede generar ilusión de profundidad, y el deseo de sentirse escuchado y comprendido. En contextos cercanos a la terapia, como la rutina DOCTOR, esta predisposición se intensifica, porque los usuarios buscan conexión emocional y pueden proyectar en la máquina una sensibilidad que en realidad no posee.

    Weizenbaum quedó tan perturbado por esa facilidad que dio un giro inesperado. El hombre que había construido uno de los programas conversacionales más famosos de la historia se convirtió en uno de los críticos más severos de la incipiente inteligencia artificial.

    Le inquietaba mucho menos lo que las máquinas podían hacer que lo que las personas estaban dispuestas a creer sobre ellas. Se preguntaba: si bastan unas pocas reglas de reformulación para que alguien deposite su intimidad en un programa de computación, ¿qué pasará cuando los programas se vuelvan realmente sofisticados?

    El “homo suggestibilis”

    Weizenbaum concluyó que incluso exposiciones muy breves a un programa relativamente simple podían inducir formas poderosas de pensamiento ilusorio en personas perfectamente normales.

    Nosotros ponemos el acento en que el efecto ELIZA es posible gracias a una disposición que nos constituye a los seres humanos como hablantes. Llamamos a esa disposición sugestibilidad. No designa un defecto a corregir ni una debilidad de los crédulos, sino una condición antropológica: somos permeables a la palabra del otro. Esa misma permeabilidad es la que hace posibles el amor, la educación, la transmisión de un saber, el psicoanálisis, y también el poder ser hipnotizados. Sin ella no habría vínculo humano alguno.

    Pero también es la sugestibilidad la que hace que no haga falta que el sistema entienda; basta con que nos devuelva palabras bajo una forma suficientemente estructurada y reconocible para que el sujeto complete la escena con su propia suposición de que su mensaje fue recibido y entendido.

    Frente a la infinidad de contenidos que circulan por medios y redes sociales acerca de la posibilidad de pensamiento y sentimiento por parte de las IA, debemos recordar, en primer lugar, nuestra sugestibilidad y en segundo, el efecto ELIZA. El verdadero riesgo aparece si los humanos dejamos de notar que el pensamiento o sentimiento que recibimos de los sistemas algorítmicos son los nuestros invertidos.

  • Miembros del Cen3 estuvieron presentes en X Congreso Internacional de AsAECA

    Miembros del Cen3 estuvieron presentes en X Congreso Internacional de AsAECA

    Entre el 22 y 24 de abril se desarrolló en Resistencia, Chaco, el X Congreso Internacional de la Asociación Argentina de Estudios de Cine y Audiovisual.

    En dependencias de la Universidad Nacional del Nordeste se reunieron investigadores, docentes, gestores, realizadores, críticos y estudiantes, entre quienes estuvieron presentes los miembros del Cen3 Sergio Romero Chamorro, Hernán Cazzaniga, Betiana Burgardt, Paula Asprella y Leandro González.

    Este último, coordinó junto con Agustín Berti de la Universidad Nacional de Córdoba y Marina Moguillansky de la Universidad Nacional de San Martín la mesa Cine y series en plataformas: mutaciones en la producción, circulación y públicos, un espacio novedoso dentro de la historia de los Congresos organizados por esta Asociación que, en esta edición, abrió esta instancia de conversación acerca del impacto e implicancias de las plataformas digitales o de Video on demand en el campo audiovisual.

    Los integrantes de Cen3 expusieron en esta mesa las siguientes ponencias:

    • Sergio Romero y Hernán Cazzaniga. De la grilla al feed. Repensar la producción de contenidos y formatos en la convergencia digital, social y cultural.
    • Betiana Burgardt y Noelia Meza. La investigación en el marco de un proyecto de animación colectivo universitario.
    • Paula Asprella, Adriana Sosa y Betiana Burgardt. Mujeres entre cámaras y rebeldías: Del aula de cine de La Plata de los 60’ al cine Argentino.
    • Leandro González. El Oligopolio Audiovisual Global: transformaciones post-plataformización.

    Así mismo, junto a representantes de la Universidad Nacional de Misiones y de la UNNE profundizaron las conversaciones con la Doctora Fran Rabelatto de la Universidad Latinoamericana (UNILA) en torno al proyecto de creación de una Red Internacional de Observatorios de la Actividad Audiovisual.

    Programa del Congreso AsAECA

  • Se publicó «Practical DTV+: Systems and Applications»

    Se publicó «Practical DTV+: Systems and Applications»

    La publicación “Practical DTV+: Systems and Applications” es un libro creado por el Grupo de Estudio SET TV 3.0 junto con la revista SET Magazine, pensado para profesionales que trabajan con televisión digital en Brasil. Su objetivo principal es explicar, de forma clara y práctica, cómo funciona DTV+ y qué tecnologías permiten el nuevo estándar de televisión abierta conocido como TV 3.0.

    Organizado por el Prof. Dr. Fernando Carlos Moura (Cen3) y por Sérgio Di Santoro, la publicación se enfoca en la aplicación práctica de las tecnologías que componen el nuevo estándar de TV abierta brasileño, mostrando cómo se implementan los sistemas y cómo operan en escenarios reales. También analiza cómo la plataforma DTV+ puede funcionar junto con la infraestructura de televisión digital que ya existe en Brasil, facilitando la transición hacia una generación más moderna de servicios televisivos.

    Además de introducir los conceptos básicos, la publicación ofrece ejemplos concretos, ilustraciones y esquemas que ayudan a comprender cómo integrar el middleware Ginga con otros elementos de la transmisión de contenidos. También se explican aspectos importantes como los diferentes tipos de receptores, la forma en que se envía la información, la seguridad del sistema y la recolección de datos para servicios más avanzados.

    Uno de los grandes aportes del libro es su enfoque práctico, que permite analizar cómo DTV+ puede adaptarse a distintos tipos de redes, modelos de negocio y reglas regulatorias. Asimismo, aborda temas actuales como las actualizaciones automáticas de software y la capacidad de que distintos sistemas trabajen juntos. Por todo ello, la obra se presenta como una referencia importante para la evolución de la televisión en Brasil y destaca a DTV+ como una pieza clave para la innovación tecnológica en la televisión del futuro.

    En el marco del Cen3, es la primera publicación en Inglés de una de sus líneas de investigación que trabaja el desarrollo de la TV 3.0 y la incorporación de la plataforma DTV+, el middleware que transforma los canales de televisión en aplicaciones (Apps).

    Reseña de Amazon

    DTV+ PRÁCTICA: SISTEMAS Y APLICACIONES es un recurso esencial para ingenieros, investigadores y profesionales que trabajan en el ecosistema de la televisión digital en Brasil. Producido por el Grupo de Trabajo SET TV 3.0 en colaboración con la revista SET, este libro ofrece una visión general completa y práctica de DTV+, la tecnología que sustenta la próxima generación de la televisión abierta brasileña.

    Con un enfoque técnico y práctico, la publicación abarca desde conceptos fundamentales hasta la implementación y las pruebas de cumplimiento, abordando temas como canales de retorno, contenido interactivo, transmisión de datos, direccionamiento, seguridad y recopilación de datos.

    Repleto de diagramas, diagramas de flujo y casos de uso reales, el contenido demuestra cómo integrar el middleware Ginga en la cadena de transmisión y cómo adaptar DTV+ a diferentes redes, modelos de negocio y entornos regulatorios.

    Más que una obra teórica, esta guía se centra en la ingeniería aplicada, haciendo hincapié en la interoperabilidad, las actualizaciones remotas y la compatibilidad con la infraestructura existente, estableciendo a DTV+ como un pilar clave de la innovación y la evolución hacia la TV 3.0 en Brasil.

    Link a la tienda Amazon

  • Inauguración del Cen3 UNTREF

    Inauguración del Cen3 UNTREF

    El Cen3 UNTREF, Centro de Investigación, Innovación y Experimentación en Producción Audiovisual en la Convergencia Digital, Social y Cultural, enmarcado en el ámbito de la Secretaría de Investigación y Desarrollo, fue creado en agosto del año 2025 bajo la Resolución Rectoral 1818/2025.

    De esta manera, la carrera de la Licenciatura en Producción Audiovisual institucionaliza un espacio de investigación, innovación, desarrollo y producción que integra actividades académicas, artísticas, culturales e industriales.

    Atendiendo a investigaciones, producciones y otros trabajos desarrollados previamente, como el Foro Internacional Permanente de Narrativas en las Fronteras, el Observatorio Audiovisual, una Incubadora de proyectos y el NeoMedia Lab, el Cen3 propone generar y visibilizar saberes que conciernen a nuestro campo de formación y desarrollo profesional. El espacio propone posicionarse, junto a la carrera, como una fuente de conocimiento académico sin descuidar la esfera industrial, fomentando la articulación entre la teoría y la práctica, desde una metodología de la investigación orientada por las prácticas en el campo de la convergencia digital, social y cultural.